Introducción al desarrollo de aplicaciones seguras
Cuando se habla de seguridad informática, es habitual pensar en cortafuegos, antivirus, cifrado o sistemas de autenticación: mecanismos que se añaden a un sistema para protegerlo. Este capítulo parte de una idea distinta, que recorre toda la asignatura: una parte muy importante de las vulnerabilidades no procede de que falten mecanismos de seguridad, sino de que el software se ha diseñado, programado, probado o desplegado sin tener en cuenta que alguien intentará abusar de él. La seguridad, por tanto, no es una capa que se coloca encima del producto terminado, sino una propiedad que emerge (o no) de decisiones tomadas a lo largo de todo el proceso de desarrollo.
A lo largo del capítulo veremos ejemplos concretos de cómo errores aparentemente menores de código y de diseño se convierten en vulnerabilidades, por qué la arquitectura de un sistema condiciona su seguridad, en qué se diferencia la programación defensiva de la programación segura y por qué las prácticas tradicionales de aseguramiento de la calidad no bastan para obtener software seguro.
Introducción
Un ejemplo de seguridad física
Empecemos con un ejemplo que no tiene nada que ver con la informática: las bisagras de las puertas de acceso a una vivienda se colocan hacia dentro, y no por casualidad.
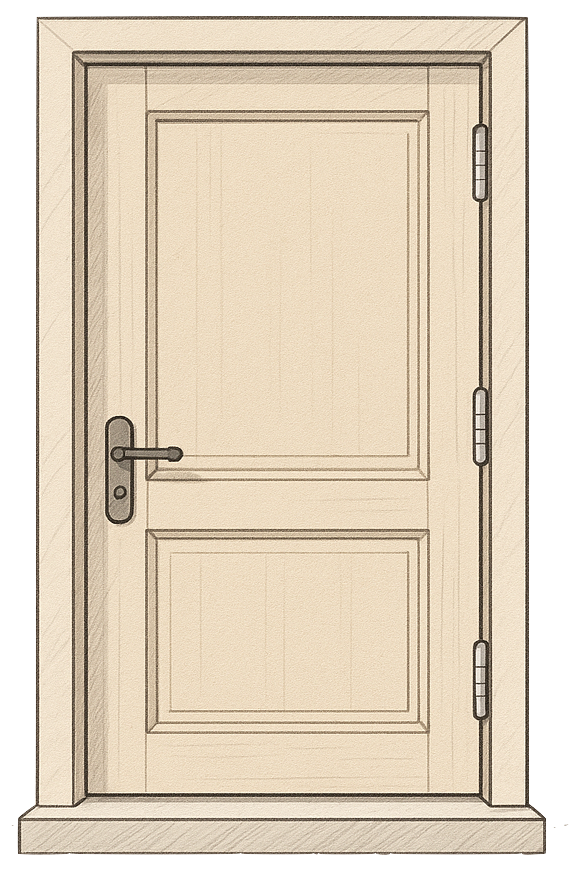
Imagina a un ladrón que quiere entrar en tu casa. Si las bisagras de la puerta principal quedan hacia fuera, el ladrón no necesita forzar la cerradura: le basta con desmontar las bisagras (por ejemplo, extrayendo sus pasadores) y retirar la puerta entera, por muy sólida que sea la cerradura. Lo que llama la atención no es un fallo de la cerradura, sino un detalle constructivo que la hace irrelevante.
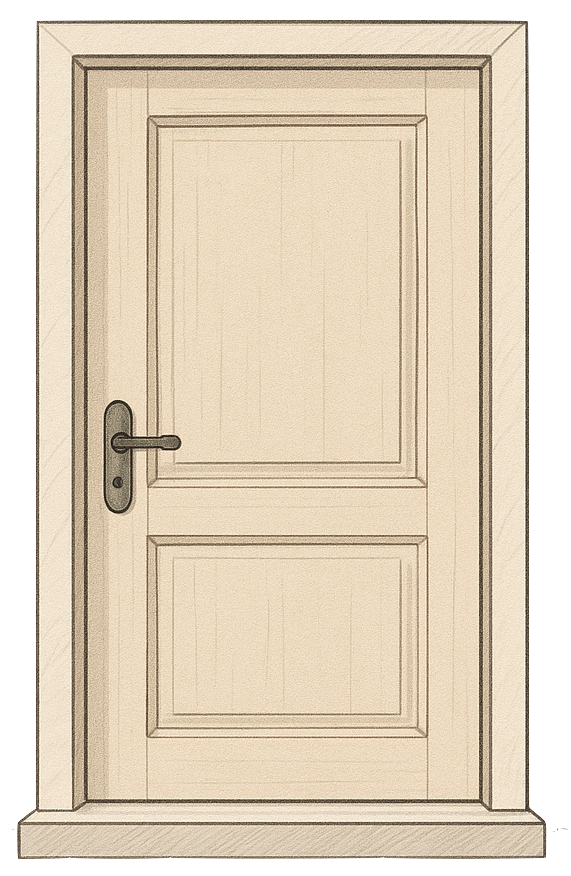
Al colocar las bisagras hacia dentro, ese vector de ataque desaparece: solo son accesibles desde el interior de la vivienda, donde el atacante, en principio, no está.
Medidas de seguridad frente a medidas seguras
El ejemplo de la puerta permite distinguir dos tipos de elementos:
- El pestillo asociado al pomo de una puerta es una medida de seguridad: su propósito explícito es impedir que alguien no autorizado abra la puerta.
- El pomo en sí, en cambio, es una medida de usabilidad: sirve para que la puerta se abra con comodidad.
Las bisagras no son una medida de seguridad, porque nadie las instala para proteger la casa, pero están implicadas en la seguridad: si se colocan mal, comprometen la protección que ofrece todo lo demás.
De aquí se extrae una idea fundamental para el resto del curso:
Medidas de seguridad ≠ medidas seguras.
Un pestillo es una medida de seguridad, pero una medida mal diseñada o mal implementada puede comprometer la seguridad en lugar de reforzarla. Y, sobre todo, implementar únicamente medidas de seguridad no garantiza una seguridad real: si el resto de elementos del sistema (como las bisagras) no se han construido pensando en un posible atacante, este siempre encontrará el camino más fácil.
La seguridad olvidada en el software
En el desarrollo de software este tipo de consideraciones no siempre se ha tenido en cuenta. Un ejemplo ilustrativo es cómo presenta el tutorial oficial de Java EE 7 una de las ventajas de los Enterprise Beans (EJB), los componentes de negocio que se ejecutan dentro de un servidor de aplicaciones Java:
[...] because the EJB container provides system-level services to enterprise beans, the bean developer can concentrate on solving business problems. The EJB container, rather than the bean developer, is responsible for system-level services, such as transaction management and security authorization.
— Oracle, The Java EE 7 Tutorial, sección 32.1.1, «Benefits of Enterprise Beans» (documentación de Oracle; copia en el Internet Archive)
El tutorial presenta como una ventaja que el contenedor EJB, y no quien programa el componente, se ocupe de los servicios del sistema, entre ellos la autorización de seguridad, para que el desarrollador pueda concentrarse en resolver el problema de negocio.
Lo que ofrece el contenedor es una medida de seguridad: comprobar, por ejemplo mediante anotaciones como @RolesAllowed, que quien invoca un método tiene el rol adecuado. Pero eso no convierte en segura la lógica de negocio que hay dentro del método. Si ese método construye una consulta concatenando parámetros, deserializa datos que no son de confianza o registra información sensible en los logs, la autorización del contenedor no lo impide: el usuario autorizado (o quien haya suplantado su identidad) podrá explotar igualmente la vulnerabilidad.
El mensaje implícito, «la seguridad es cosa del contenedor», es justamente la confusión entre medidas de seguridad y medidas seguras que veíamos con las bisagras de la puerta. El mismo patrón aparece en la documentación de muchos frameworks y bibliotecas que prometen resolver la seguridad por el desarrollador.
El problema de este planteamiento es que muchas de las vulnerabilidades en los sistemas informáticos no se deben a fallos en las medidas de seguridad, sino a otros aspectos del desarrollo. Por ejemplo, usar una biblioteca vulnerable para el manejo de imágenes puede permitir a un atacante ejecutar código en el servidor, por muy bien configurados que estén la autenticación y el control de acceso. Ningún contenedor ni administrador puede corregir mediante configuración un desbordamiento de búfer en el código de la aplicación.
Muchos sistemas de software, en definitiva, no se construyen con la seguridad en mente. Las tecnologías reactivas, como los cortafuegos, pueden aliviar algunos ataques contra los servidores, pero no abordan el problema principal: el software mal hecho. Un cortafuegos filtra tráfico por puertos, direcciones o patrones conocidos, pero no puede saber si una petición HTTP perfectamente legítima en su forma va a explotar un fallo en la lógica de la aplicación.
Para poner en práctica la seguridad del software es necesario:
- adoptar prácticas de ingeniería, igual que se hace para conseguir otras propiedades como la fiabilidad o el rendimiento; y
- considerar la seguridad como parte del ciclo de vida de desarrollo del software (SDLC = Software Development Life Cycle), y no como una actividad aislada al final del proceso.
Puntos de seguridad en el ciclo de vida del desarrollo
Los puntos del ciclo de vida más relevantes para la seguridad se resumen en la siguiente figura, que muestra los llamados touchpoints de seguridad del software: actividades de seguridad que se acoplan a los artefactos que se producen en cada fase del desarrollo.

La figura recorre las fases clásicas del desarrollo (requisitos y casos de uso, arquitectura y diseño, planes de prueba, código, pruebas y resultados, y realimentación desde el entorno de producción) y asocia a cada una sus actividades de seguridad. Podemos resumir el papel de la seguridad en cada etapa así:
- Requisitos: identificar las necesidades de confidencialidad, integridad y disponibilidad del sistema, y describir casos de abuso (cómo podría utilizarse el sistema de forma maliciosa), además de los casos de uso habituales.
- Arquitectura y diseño: prever amenazas y modelar riesgos, por ejemplo con STRIDE, antes de que las decisiones de diseño queden fijadas en el código.
- Construcción: escribir código robusto y revisarlo con ayuda de herramientas de análisis estático (SAST = Static Application Security Testing) y de análisis de dependencias (SCA = Software Composition Analysis).
- Pruebas: incluir casos de uso maliciosos y pruebas de penetración, no solo pruebas de que el sistema hace lo que debe.
- Calidad y mantenimiento: corregir vulnerabilidades y mantener actualizadas las dependencias una vez el sistema está en producción.
Las flechas circulares de la figura subrayan que el proceso es iterativo: lo que se aprende en operación (incidentes, vulnerabilidades descubiertas) debe realimentar los requisitos y el diseño de las siguientes versiones.
Alcance de la asignatura
Esta asignatura se centra en la seguridad en los siguientes puntos del ciclo de vida:
- arquitectura y diseño;
- construcción, entendida en sentido amplio y no solo como implementación o escritura de código; y
- operaciones, lo que incluye también la configuración y el despliegue del software.
Código y diseño
Comenzamos con algunos ejemplos sencillos que muestran cómo un fallo en el código, o en el diseño que lo sustenta, da lugar a una vulnerabilidad.
Ejemplo: entrada no validada
Muchas vulnerabilidades tienen su origen en no validar la entrada que proporciona el usuario. Consideremos esta función en Python:
def greet_user(name):
    print(f"Hola {name}!")

# Supongamos que la entrada proviene de un parámetro web
user_input = "<script>alert('XSS')</script>"
greet_user(user_input)
Desde el punto de vista funcional, el programa es correcto: recibe un nombre y lo saluda. Sin embargo, el nombre procede de un parámetro web, es decir, lo controla quien hace la petición. Si el resultado se muestra en una página web, el navegador no verá un nombre, sino una etiqueta <script> y ejecutará el código JavaScript que contiene. Es lo que se conoce como Cross-Site Scripting (XSS): el atacante consigue que el navegador de la víctima ejecute código arbitrario en el contexto del sitio web, lo que le permite, por ejemplo, robar cookies de sesión o realizar acciones en nombre del usuario.
Una solución más segura consiste en neutralizar los caracteres con significado especial en HTML antes de mostrarlos:
import html

def greet_user(name):
    safe_name = html.escape(name)
    print(f"Hola {safe_name}!")
La función html.escape transforma caracteres como <, > o & en sus entidades HTML equivalentes (<, >, &), de forma que el navegador los muestra como texto en lugar de interpretarlos como marcado. El nombre malicioso se mostrará literalmente en pantalla, pero no se ejecutará.
Ejemplo: desbordamiento de búfer
El desbordamiento de búfer (buffer overflow) es una de las vulnerabilidades clásicas por excelencia. Se produce cuando un programa ofrece a los atacantes la posibilidad de escribir arbitrariamente en memoria, más allá de los límites de la zona reservada para un dato. Veamos esta función en C:
void trouble() {
  int a = 32; /* integer */
  char line[128]; /* character array */
  gets(line); /* read a line from stdin */
}
La función reserva un vector de 128 caracteres y lee en él una línea de la entrada estándar mediante gets(). El problema es que gets() no recibe el tamaño del búfer de destino: sigue copiando caracteres hasta encontrar un salto de línea, por larga que sea la línea. Si el atacante proporciona más de 128 caracteres, el exceso se escribe en las posiciones de memoria contiguas al vector.
Una solución más segura sustituye gets() por fgets(), que sí permite indicar el tamaño máximo que se puede escribir:
void trouble() {
  int a = 32; /* integer */
  char line[128]; /* character array */
  fgets(line, sizeof(line), stdin);  /* read a line from stdin */
}
Con fgets(line, sizeof(line), stdin) la lectura se detiene, como mucho, al llenar el búfer (reservando espacio para el carácter nulo final), de modo que es imposible escribir fuera de él.
Estructura en memoria
Para entender por qué un desbordamiento de búfer es tan peligroso, hay que fijarse en cómo se organiza la memoria durante la llamada a una función. Cuando se invoca trouble(), se crea en la pila (stack) un marco de pila (stack frame) que contiene, entre otras cosas, las variables locales de la función y la dirección de retorno, es decir, la instrucción en la que debe continuar la ejecución cuando la función termine. En las figuras, 0xNN representa la dirección de comienzo de la pila.
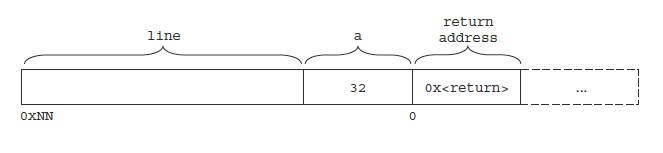
En una ejecución normal, la línea leída ocupa como mucho el espacio reservado para line, y el resto del marco de pila (la variable a y la dirección de retorno) permanece intacto:
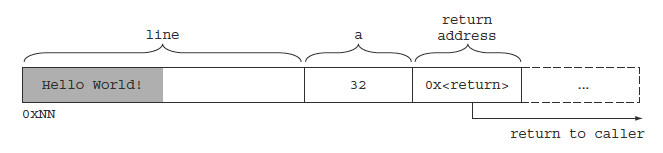
En un ataque por desbordamiento de búfer, en cambio, la entrada es lo bastante larga como para sobrescribir las posiciones de memoria que siguen al vector, incluida la dirección de retorno:
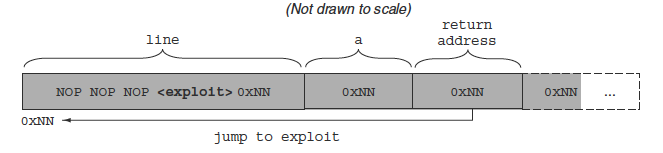
Si el atacante controla la dirección de retorno, controla qué instrucción se ejecutará al terminar la función: puede redirigir la ejecución hacia código que él mismo ha introducido en el búfer o hacia fragmentos de código ya existentes en el programa. Lo que empezó como un simple error al leer una línea se convierte así en la posibilidad de ejecutar código arbitrario.
Errores de implementación
Este desbordamiento de búfer se debe al (mal) uso de API vulnerables, como gets(), strcpy() y otras funciones de la biblioteca estándar de C que copian datos sin comprobar el tamaño del destino. Se trata de un error de implementación (implementation bug): el diseño de la función no tiene nada de malo, pero la forma en que se ha escrito el código introduce la vulnerabilidad.
Para evitar el mal uso de API vulnerables existen varias técnicas complementarias:
- Revisión de código (code review) manual, en la que otra persona examina el código buscando, entre otras cosas, construcciones peligrosas.
- Análisis estático automatizado, mediante herramientas de SAST, que examinan el código fuente sin ejecutarlo y detectan patrones conocidos de vulnerabilidad, como la llamada a
gets(). - Análisis de dependencias, integrado en el ciclo de vida, mediante herramientas de SCA, que identifican las bibliotecas de terceros que usa el proyecto y avisan de las que tienen vulnerabilidades conocidas.
- Análisis dinámico, mediante herramientas de Dynamic Application Security Testing (DAST), que atacan la aplicación en ejecución, enviándole entradas manipuladas y observando su comportamiento.
Sin embargo, el análisis de código no basta para resolver todos los problemas de seguridad: según Chess & West (Secure Programming with Static Analysis, 2007), menos del 50 % de los problemas de seguridad pueden detectarse de este modo. El resto tiene su origen en otras actividades del desarrollo.
Entre esas otras actividades del desarrollo con implicaciones en la seguridad destacan, fundamentalmente, la arquitectura y el diseño. Los problemas arquitectónicos son muy difíciles, y a veces imposibles, de encontrar mirando solo el código. Por ejemplo, la ausencia de una separación clara entre módulos con diferentes niveles de privilegio puede dar lugar a vulnerabilidades graves que no se detectan en el análisis de código, porque cada línea, examinada de forma aislada, parece correcta.
Ejemplo: arquitectura insegura
Consideremos un servicio web que ejecuta consultas SQL construidas directamente a partir de los parámetros HTTP:
@app.route('/user')
def user_info():
    name = request.args['name']
    query = f"SELECT * FROM users WHERE name='{name}'"
    return db.execute(query)
El valor del parámetro name se inserta tal cual dentro del texto de la consulta. Si un atacante envía como nombre algo como ' OR '1'='1, la consulta resultante devuelve todos los usuarios de la tabla; con entradas más elaboradas podría modificar o borrar datos. Es una inyección SQL: el atacante consigue que sus datos se interpreten como parte del código SQL.
Aquí el fallo no es solo de código: es el diseño el que permite la inyección SQL. La capa que atiende las peticiones HTTP accede directamente a la base de datos y construye consultas concatenando texto, sin ninguna capa intermedia que separe los datos de las instrucciones. La solución, por tanto, implica modificar la arquitectura, por ejemplo usando un ORM (Object-Relational Mapping) o una capa de acceso a datos controlada que utilice consultas parametrizadas, de forma que ningún componente de la aplicación pueda construir consultas a partir de la entrada del usuario sin pasar por ella.
Principios de diseño seguro
El ejemplo anterior ilustra que la seguridad depende de cómo se reparten las responsabilidades entre componentes. Existen una serie de principios de diseño seguro que orientan esas decisiones:
- Defensa en profundidad: disponer varias capas de seguridad, de forma que el fallo de una no comprometa todo el sistema. Volviendo a la puerta, no basta con un buen pestillo si las bisagras ceden.
- Mínimo privilegio: cada módulo o usuario solo debe tener los permisos mínimos necesarios para su tarea. Así, si un componente queda comprometido, el daño que puede causar el atacante es limitado.
- Separación de responsabilidades: la lógica de negocio no debe ejecutar tareas del sistema. Mantener separadas las distintas funciones facilita razonar sobre la seguridad de cada una y evita que un fallo en una se propague a las demás.
- Valores por defecto seguros (fail-safe defaults): por defecto, se debe negar el acceso o fallar de forma controlada. Si algo no está explícitamente permitido, debe estar prohibido; y ante un error inesperado, el sistema debe quedar en un estado seguro, no en uno abierto.
La importancia del diseño: mantenibilidad
El diseño es clave para la seguridad porque asegura la mantenibilidad, y un código difícil de entender, de revisar y de modificar es también un código en el que las vulnerabilidades pasan desapercibidas y en el que corregirlas resulta costoso y arriesgado.
Mejorar la mantenibilidad implica varias actividades:
- Hallar code smells (síntomas en el código que indican un problema de diseño subyacente) u otros problemas de mantenibilidad.
- Aplicar refactoring, es decir, cambiar el diseño o la implementación sin cambiar la funcionalidad, para mejorar la estructura interna del código.
- Usar herramientas de linting para verificar la calidad y el estilo del código de forma automática.
- Seguir estándares de codificación (coding standards) y catálogos de debilidades y vulnerabilidades, como Common Weakness Enumeration (CWE), las normas de CERT, Common Vulnerabilities and Exposures (CVE) o la National Vulnerability Database (NVD).
La relación entre mantenibilidad y seguridad se desarrolla en el artículo de Ann Campbell For secure code, maintainability matters ("Para tener código seguro, la mantenibilidad importa"). Un ejemplo conocido es el de algunas vulnerabilidades, como Heartbleed, que tardaron en detectarse en parte porque el código en el que se encontraban estaba mal formateado, lo que dificultaba su revisión por parte de personas.
Estándares de codificación
Un dato revelador es que el 60 % de las debilidades recogidas en CWE no son exactamente vulnerabilidades. CWE no es solo una lista de fallos explotables, sino un catálogo de debilidades del software: defectos que, en determinadas circunstancias, pueden facilitar o dar lugar a una vulnerabilidad.
La vista CWE-699: Software Development organiza las debilidades según conceptos habituales en el desarrollo de software y contiene debilidades de categorías muy diversas, por ejemplo:
- problemas de complejidad;
- errores numéricos; y
- malas prácticas de codificación.
Entre las malas prácticas de codificación encontramos debilidades que, a primera vista, parecen meras cuestiones de estilo o de calidad:
- CWE-478: falta del caso por defecto (Missing default case) en una sentencia de selección múltiple como
switch. - CWE-581: violación del modelo de objetos por definir solo uno de los métodos
equalsyhashCode(Object Model Violation: Just One of Equals and Hashcode Defined).
Más adelante veremos que estas "malas prácticas" pueden tener consecuencias directas sobre la seguridad.
Tendencias 2019-2025
MITRE publica la lista CWE Top 25 Most Dangerous Software Weaknesses, con las 25 debilidades de software más peligrosas. Comparando las ediciones del periodo 2019-2025, algunas debilidades muestran una tendencia al alza:
- CWE-862: Missing Authorization (falta de autorización).
- CWE-918: Server-Side Request Forgery (SSRF) (falsificación de peticiones del lado del servidor).
- CWE-639: Authorization Bypass Through User-Controlled Key (elusión de la autorización mediante una clave controlada por el usuario).
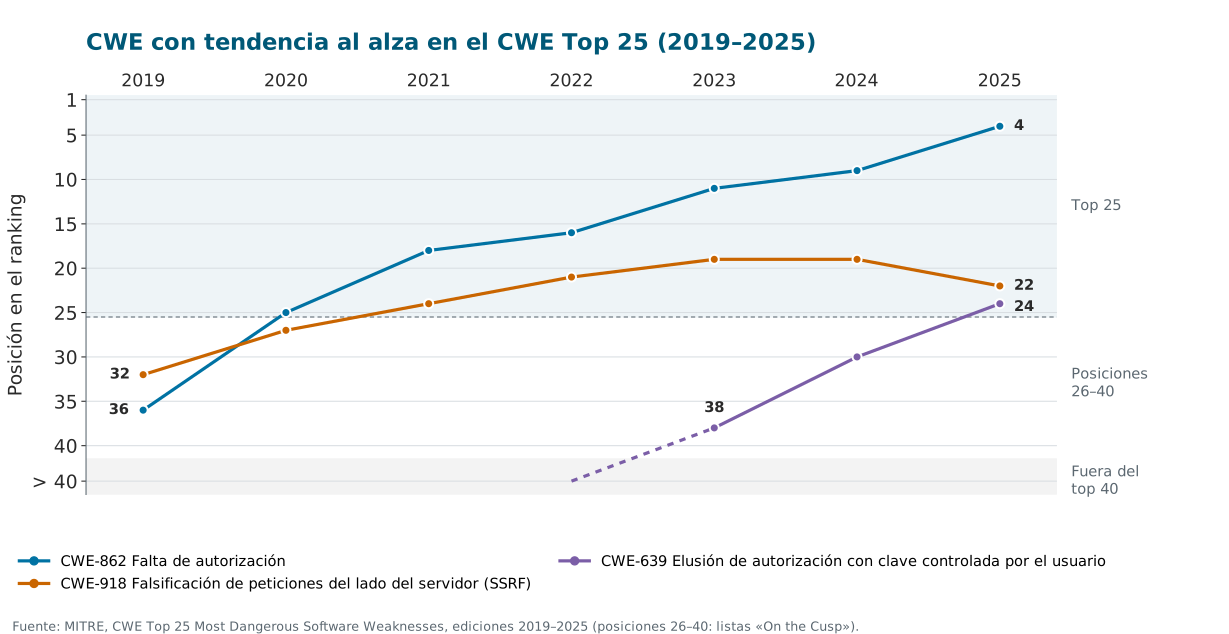
En las ediciones más recientes, CWE-862 llega al 4.º puesto en 2025 y CWE-639 entra en el Top 25 (24.º), tras figurar por primera vez entre las 40 primeras en 2023. CWE-918, en cambio, retrocede del 19.º puesto en 2023 y 2024 al 22.º en 2025, de modo que su tendencia al alza ya no es tan clara.
Otras, en cambio, muestran una tendencia a la baja:
- CWE-190: Integer Overflow or Wraparound (desbordamiento o vuelta de enteros).
- CWE-732: Incorrect Permission Assignment for Critical Resource (asignación incorrecta de permisos a un recurso crítico).
- CWE-611: Improper Restriction of XML External Entity Reference (restricción inadecuada de referencias a entidades externas XML).
- CWE-426: Untrusted Search Path (ruta de búsqueda no confiable).
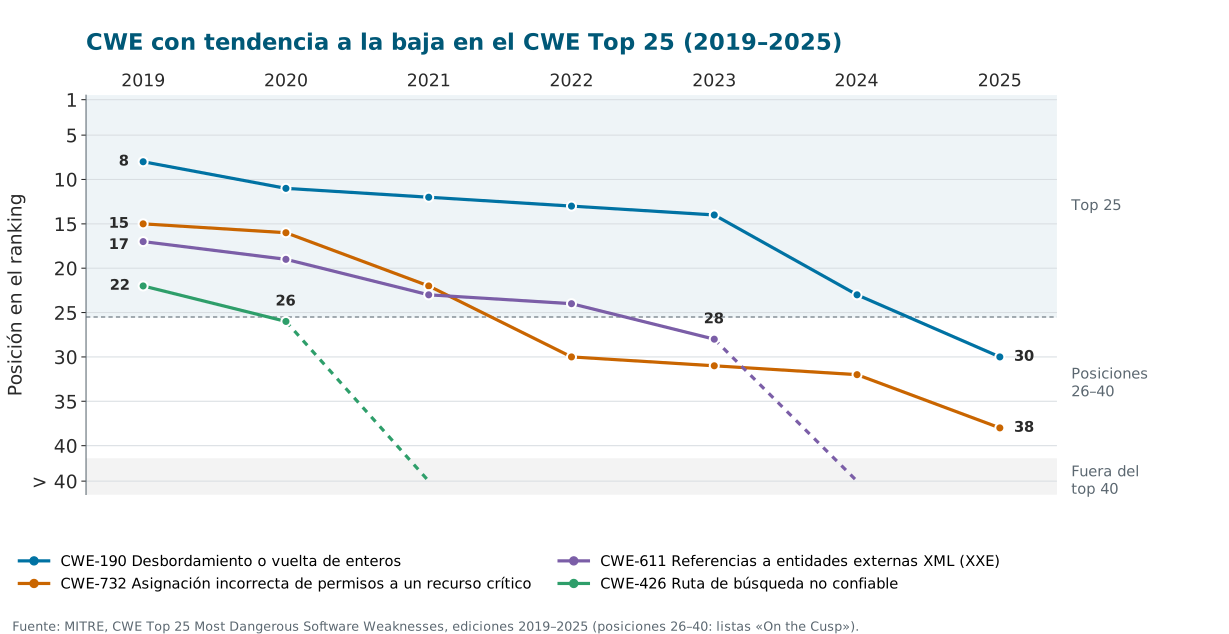
La tendencia se mantiene en 2024 y 2025: CWE-190 sale del Top 25 (23.º en 2024 y 30.º en 2025), CWE-732 baja hasta el puesto 38 y CWE-611 queda fuera de las 40 primeras desde 2024, como le ocurrió a CWE-426 a partir de 2021.
Llama la atención que las debilidades al alza tienen mucho que ver con decisiones de diseño (dónde y cómo se comprueba la autorización, qué peticiones puede hacer el servidor en nombre del usuario), mientras que algunas de las que bajan son errores de implementación o de configuración más localizados, que las herramientas y los lenguajes modernos ayudan a prevenir.
CWE-581 y la disponibilidad
No respetar la CWE-581 puede llevar a incumplir un requisito de seguridad. En lenguajes como Java, el contrato de los objetos exige que, si a.equals(b) es verdadero, entonces a.hashCode() == b.hashCode(). Si una clase redefine solo uno de los dos métodos, esta invariante puede romperse, lo que causa problemas cuando se almacenan objetos de esa clase en una colección.
Cuando los objetos de la clase se usan como claves de una Hashtable, o se insertan en un Map o en un Set basados en hash, es crítico que objetos iguales tengan el mismo código hash, porque la colección usa ese código para decidir en qué posición buscar. Si no se cumple, puede ocurrir que un objeto esté en la colección pero no se encuentre al buscarlo. El dato existe, pero el sistema no es capaz de recuperarlo: se está incumpliendo un requisito de disponibilidad.
Este ejemplo muestra por qué la seguridad no se limita a la confidencialidad. Una mala práctica de codificación aparentemente inofensiva puede comprometer la disponibilidad de la información, que es uno de los tres pilares clásicos de la seguridad junto con la confidencialidad y la integridad.
Arquitectura
Robert C. Martin define la arquitectura del software en estos términos:
La arquitectura de un sistema software es la forma dada al sistema por aquellos que lo construyen. La forma es la división del sistema en componentes, la disposición de esos componentes y la manera en que se comunican entre sí.
— Robert C. Martin
Hemos visto que el análisis de código no basta para detectar todos los problemas de seguridad. Para un enfoque completo de la seguridad del software es necesario combinar las revisiones de código con el análisis arquitectónico.
Arquitectura y seguridad
La relación entre arquitectura y seguridad es directa: la arquitectura del software decide qué componentes conforman un sistema y cómo interactúan entre sí. Esas decisiones determinan dónde están los límites de confianza, qué componente tiene acceso a qué datos, por dónde entra la información externa y qué privilegios tiene cada parte. El ejemplo de la inyección SQL lo mostraba: el defecto estaba en permitir que la capa web hablara directamente con la base de datos construyendo consultas de texto.
Otras actividades relacionadas con el desarrollo de software también son muy importantes para la seguridad, pero no las trataremos aquí. Esta asignatura no se centra especialmente en:
- técnicas criptográficas avanzadas;
- gestión de identidades;
- control de acceso;
- y otras medidas de seguridad específicas.
Lo que sí nos interesa son aquellos aspectos del desarrollo de software que, en principio, no parecen relacionados con la seguridad, pero que la ponen en riesgo si no se hacen bien. Son las "bisagras" del software: la validación de entradas, la elección de API, la organización de los componentes, la mantenibilidad del código, la configuración y el despliegue.
Modelado de amenazas
Todo esto significa que, en buena medida, hay que saber programación y técnicas de desarrollo de software para poder garantizar la seguridad. Aun así, quienes no disfrutan programando encuentran un cierto respiro en el modelado de amenazas (threat modeling), una actividad que trabaja sobre diagramas y sobre el diseño de la arquitectura más que sobre el código. Sus objetivos son:
- identificar los requisitos de seguridad;
- señalar las amenazas y vulnerabilidades;
- cuantificar la criticidad de las amenazas y vulnerabilidades; y
- priorizar los métodos de reparación.
Existen numerosos métodos de threat modeling aplicables a la arquitectura del software. Entre ellos destacan:
- STRIDE, propuesto por Microsoft dentro de su SDLC. Su nombre es un acrónimo de las categorías de amenazas que analiza: suplantación de identidad (Spoofing), manipulación (Tampering), repudio (Repudiation), revelación de información (Information Disclosure), denegación de servicio (Denial of Service) y elevación de privilegios (Elevation of Privilege). Por ejemplo, en el diseño de una API web, STRIDE identificaría amenazas de suplantación (S), de inyección (T), de denegación de servicio (D) y de escalada de privilegios (E).
- LINDDUN, centrado en mitigar amenazas a la privacidad.
- Synopsys, la propuesta de modelado de amenazas de esta empresa.
La siguiente figura muestra un ejemplo del tipo de modelo con el que se trabaja en el modelado de amenazas:
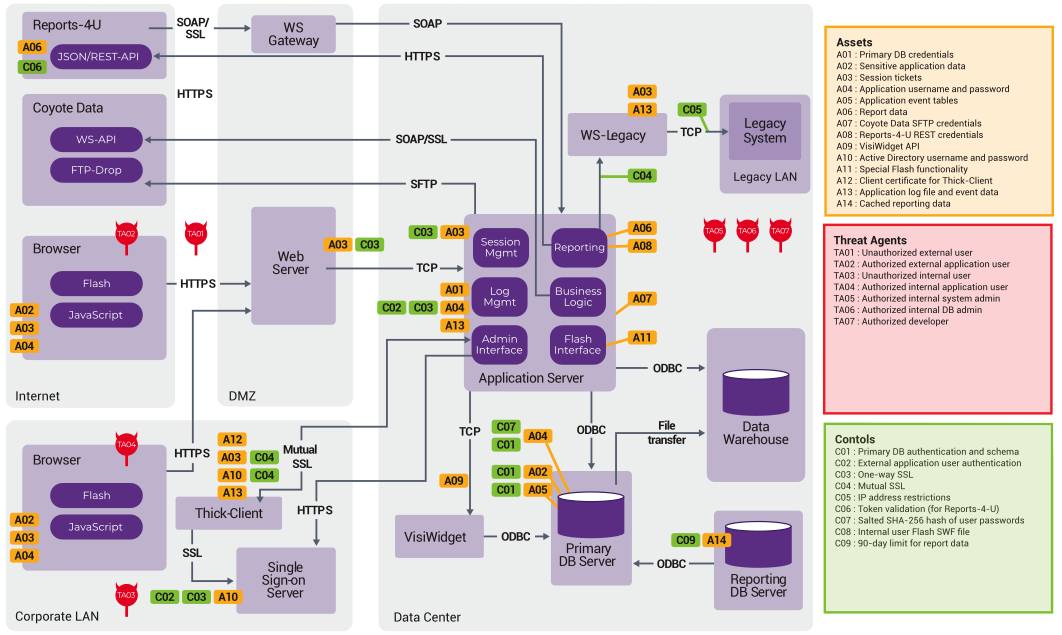
El diagrama representa la arquitectura de un sistema con componentes repartidos en distintas zonas de red: navegadores y clientes en Internet y en la red corporativa, un servidor web en la DMZ, un servidor de aplicaciones y varias bases de datos en el centro de datos, y un sistema heredado en su propia red. Sobre esa arquitectura se anotan tres tipos de elementos:
- Activos que hay que proteger: credenciales, datos sensibles, tickets de sesión, ficheros de log, etc.
- Agentes de amenaza: usuarios externos e internos, autorizados o no, administradores y desarrolladores.
- Controles de seguridad aplicados: autenticación, SSL unidireccional o mutuo, restricciones por dirección IP, hash con sal de contraseñas, etc.
Superponer estas tres capas sobre el diagrama de componentes permite razonar sobre qué agente puede alcanzar qué activo, por qué camino y qué controles se interponen, que es precisamente la esencia del modelado de amenazas.
Asistentes de programación basados en IA
Herramientas como Windsurf o GitHub Copilot podrían parecer otro respiro para quienes no disfrutan programando. Los asistentes de programación basados en IA generan código a partir de descripciones en lenguaje natural o completan el que vamos escribiendo, pero eso no los exime de producir código vulnerable. Para valorarlo, se propone la siguiente práctica:
- Abrir con VS Code los siguientes ficheros de código fuente Python, disponibles en
ejemplos/python/del repositorio de la asignatura:server-side-request.pytemporary-file-creation.pycryptographic-key-generation.py
- Comprobar las reglas de SonarSource correspondientes:
- RSPEC-5144: las peticiones del lado del servidor no deben ser vulnerables a ataques de falsificación (Server-side requests should not be vulnerable to forging attacks).
- RSPEC-5445: no deben usarse métodos inseguros de creación de ficheros temporales (Insecure temporary file creation methods should not be used).
- RSPEC-4426: la generación de claves criptográficas debe basarse en parámetros robustos (Cryptographic key generation should be based on strong parameters).
- Probar Windsurf o GitHub Copilot sobre esos ficheros, observando si las sugerencias del asistente detectan y corrigen las vulnerabilidades o, por el contrario, las mantienen o introducen otras nuevas.
- Probar otros entornos de desarrollo con asistencia de IA, como Cursor o el modo agente de Copilot.
La conclusión que se busca es que, para evaluar críticamente el código que produce un asistente, sigue siendo imprescindible saber reconocer las debilidades que contiene.
Programación defensiva
La programación defensiva consiste en garantizar el comportamiento de todo elemento de una aplicación ante cualquier situación de uso, por incorrecta o imprevisible que esta pueda parecer. Es decir, el programador no da por supuesto que las funciones se van a invocar con argumentos válidos ni que el entorno se va a comportar como se espera, sino que comprueba esas condiciones y reacciona de forma controlada cuando no se cumplen.
Programación defensiva frente a programación segura
La programación defensiva no garantiza un software seguro, porque al hablar de seguridad se supone la existencia de un adversario. La programación defensiva protege frente a errores accidentales: argumentos nulos, ficheros inexistentes, valores fuera de rango. La seguridad, en cambio, debe considerar entradas diseñadas deliberadamente por alguien que conoce (o investiga) el funcionamiento del programa y busca precisamente los casos que el programador no previó.
La diferencia entre ambos enfoques se aprecia bien a la luz de la llamada navaja de Hanlon, un aforismo muy popular en el mundo de la informática:
Never attribute to malice that which is adequately explained by stupidity.
«No atribuyas a la maldad lo que se explica adecuadamente por la torpeza».
Como regla de convivencia y como criterio para depurar programas, la navaja de Hanlon es sensata: la inmensa mayoría de los fallos se deben a errores y descuidos, no a la mala intención de nadie. Es, de hecho, la hipótesis de trabajo de la programación defensiva, que protege el programa frente a usos incorrectos accidentales.
| Programación defensiva | Programación segura | |
|---|---|---|
| Ante un uso incorrecto, supone… | un error o un descuido | un ataque deliberado |
| La navaja de Hanlon… | es un buen criterio | no sirve: el adversario existe |
En seguridad, sin embargo, la navaja de Hanlon no sirve. Aunque la mayor parte de los usos incorrectos sean accidentales, basta con que uno sea malicioso para comprometer el sistema, y un atacante no se limita a los errores que aparecerían por azar: busca deliberadamente las entradas más dañinas. Por eso la programación segura tiene que diseñarse suponiendo que la maldad existe, aunque casi siempre sea la torpeza la que explica lo que ocurre.
La seguridad del software significa crear programas que se comportan correctamente incluso en presencia de un comportamiento malicioso.
Ejemplo en C
Consideremos esta sencilla función en C que imprime un mensaje en un fichero:
void printMsg(FILE* file, char* msg) {
  fprintf(file, msg);
}
Esta función falla si alguno de sus argumentos es NULL. Para evitarlo, aplicando programación defensiva, comprobamos ambos argumentos antes de usarlos y registramos un error si alguno no es válido:
void printMsg(FILE* file, char* msg) {
  if (file == NULL) {
    logError("attempt to print message to null file");
  } else if (msg == NULL) {
    logError("attempt to print null message");
  } else {
    fprintf(file, msg);
  }
}
Ahora la función se comporta de forma controlada ante punteros nulos: en lugar de provocar un fallo del programa, registra el error (los mensajes significan, respectivamente, "intento de imprimir un mensaje en un fichero nulo" e "intento de imprimir un mensaje nulo").
Hay alternativas mejores para el tratamiento de los valores nulos, como los Optionals, que hacen explícita en el tipo de datos la posible ausencia de valor.
Por qué no es suficiente
Desde la perspectiva de la seguridad, esta solución no es suficiente. El problema está en la llamada fprintf(file, msg): el segundo argumento de fprintf no es un texto cualquiera, sino una cadena de formato, en la que secuencias como %s, %x o %n indican a la función que debe leer argumentos adicionales (o, en el caso de %n, escribir en memoria). Como msg se pasa directamente como cadena de formato, un atacante que controle su contenido puede especificar una cadena con un formato malicioso, pensada para leer el contenido de la pila o para escribir en posiciones de memoria arbitrarias y provocar un desbordamiento.
Las comprobaciones de NULL no protegen en absoluto frente a esto: el mensaje no es nulo, simplemente es malicioso. La programación defensiva ha resuelto el problema del uso accidentalmente incorrecto, pero no el del uso deliberadamente hostil. La forma segura de escribir la llamada es no usar nunca datos externos como cadena de formato, por ejemplo fprintf(file, "%s", msg), de modo que el mensaje se trate siempre como texto.
Recordemos de nuevo el marco de pila de una llamada a función, antes de la ejecución:
y tras un ataque por desbordamiento de búfer:
El efecto que busca el atacante con una cadena de formato maliciosa es el mismo que en el ejemplo de gets(): alterar el contenido del marco de pila, y en particular la dirección de retorno, para tomar el control de la ejecución.
La falacia de la calidad
Las organizaciones que desarrollan software suelen contar con grupos de ingenieros de calidad (Quality Assurance, QA) dedicados a escribir y ejecutar pruebas y a evaluar sus resultados. Sería tentador pensar que, reforzando estos equipos, se obtendría software más seguro. Sin embargo, es casi imposible mejorar la seguridad del software solo mejorando la QA, por varias razones:
- Las pruebas funcionales sirven para asegurarse de que los usuarios típicos, con necesidades típicas, quedan satisfechos, pero no sirven para encontrar defectos de seguridad que no estén relacionados con funcionalidades específicas de seguridad. Un atacante no es un usuario típico.
- La mayor parte de las pruebas de software comparan la implementación con los requisitos, y este enfoque no es adecuado para encontrar problemas de seguridad.
- Los problemas de seguridad no suelen ser violaciones de los requisitos, sino funcionalidades no deliberadas: cosas que el programa permite hacer sin que nadie lo haya pretendido, y que lo hacen inseguro.
Software fiable frente a software seguro
Esta última idea permite distinguir dos propiedades que a menudo se confunden:
- El software fiable hace lo que se supone que tiene que hacer.
- El software seguro hace lo que se supone que tiene que hacer, y nada más.
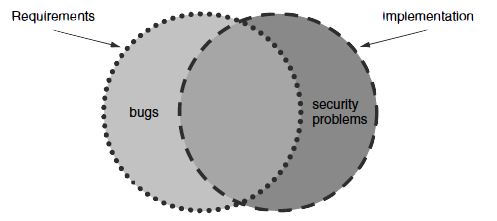
La figura lo representa con dos conjuntos que se solapan: lo que dicen los requisitos y lo que realmente hace la implementación. La zona de los requisitos que la implementación no cubre corresponde a los bugs convencionales: cosas que el programa debería hacer y no hace, y que las pruebas funcionales están pensadas para detectar. La zona de la implementación que queda fuera de los requisitos corresponde a los problemas de seguridad: cosas que el programa hace sin que nadie lo haya pedido. Como las pruebas se derivan de los requisitos, esa zona queda, por construcción, fuera de su alcance.
Ejemplo con JSP
Consideremos este fragmento de una página JSP:
<c:if test="${param.sayHello}">
  <!-- Let's welcome the user ${param.name} -->
  Hello ${param.name}!
</c:if>
Si el parámetro sayHello está activado, la página muestra un saludo con el nombre recibido en el parámetro name (el comentario HTML dice "demos la bienvenida al usuario"). Es muy posible que este código cumpla los requisitos: una prueba funcional que envíe un nombre corriente comprobará que el saludo aparece correctamente. Sin embargo, cumplir los requisitos no significa estar libre de vulnerabilidades.
De hecho, este código es vulnerable a ataques de Cross-Site Scripting (XSS) por dos vías:
- En el saludo: el valor de
param.namese inserta en la página sin ningún tipo de escape, igual que en el ejemplo de Python del principio del capítulo, de modo que un atacante puede construir un enlace cuyo parámetronamecontenga código JavaScript que se ejecutará en el navegador de la víctima. - En el comentario HTML: aunque el comentario no se muestra en pantalla, la expresión se evalúa en el servidor y su resultado se envía al navegador, por lo que un atacante podría cerrar el comentario e inyectar contenido también por esa vía.
La solución pasa por escapar la salida, por ejemplo con la etiqueta c:out de JSTL o la función fn:escapeXml.
Las limitaciones de las pruebas de caja negra
Ninguna cantidad de pruebas de caja negra es suficiente para revelar un problema como el anterior, por varias razones:
- Las pruebas de caja negra solo pueden comenzar cuando el sistema está terminado. Una vez desplegado, atacantes y defensores están en situación de igualdad: los atacantes también pueden estudiar el software desde fuera, con las mismas herramientas.
- La suma de las horas que pueden dedicar todos los posibles atacantes puede superar con creces la suma de las horas que dedican los defensores a hacer pruebas. Por pura estadística, los atacantes pueden encontrar más vulnerabilidades.
- Encontrar una prueba fallida es un signo de que hay problemas, pero pasar una prueba con éxito no significa mucho. Las pruebas pueden demostrar la presencia de defectos, pero no su ausencia, y en seguridad lo que importa es precisamente la ausencia de comportamientos no deseados.
Que una aplicación supere todas sus pruebas funcionales solo indica que hace lo que se esperaba en los casos que se han probado. No dice nada sobre lo que hace ante entradas que nadie previó, que son justamente las que buscará un atacante.
Ideas clave
- Las medidas de seguridad no garantizan por sí solas un sistema seguro: muchos fallos proceden de elementos que no son medidas de seguridad pero están implicados en ella, como las bisagras de una puerta. Tampoco basta con delegar la seguridad en un contenedor o un framework: sus medidas de seguridad no hacen segura la lógica de la aplicación.
- La seguridad debe integrarse en todo el ciclo de vida del desarrollo (requisitos, arquitectura y diseño, construcción, pruebas y operación), y no confiarse a tecnologías reactivas como los cortafuegos.
- Errores de implementación como no validar la entrada o usar API vulnerables (
gets(),strcpy()) dan lugar a vulnerabilidades como XSS o desbordamientos de búfer; la revisión de código, SAST, SCA y DAST ayudan a detectarlos. - El análisis de código detecta menos de la mitad de los problemas de seguridad; el resto se origina en la arquitectura y el diseño, por lo que es necesario combinar revisión de código y análisis arquitectónico.
- Principios como la defensa en profundidad, el mínimo privilegio, la separación de responsabilidades y los valores por defecto seguros guían un diseño seguro, y la mantenibilidad del código es en sí misma un factor de seguridad.
- Las debilidades que más han subido en el CWE Top 25 entre 2019 y 2025, como la falta de autorización (CWE-862), están ligadas a decisiones de diseño, mientras que algunas de las que bajan son errores de implementación más localizados.
- El modelado de amenazas (STRIDE, LINDDUN, etc.) permite razonar sobre activos, agentes de amenaza y controles a partir de los diagramas de la arquitectura.
- La programación defensiva protege frente a usos accidentalmente incorrectos, pero no frente a un adversario. La navaja de Hanlon («no atribuyas a la maldad lo que se explica por la torpeza») es un buen criterio para la programación defensiva, pero no para la segura: el software seguro debe comportarse correctamente incluso ante entradas maliciosas.
- El software fiable hace lo que debe; el software seguro hace lo que debe y nada más. Por eso las pruebas funcionales y de caja negra, basadas en requisitos, no bastan para garantizar la seguridad.