DevSecOps
En el capítulo de introducción vimos que la seguridad del software no puede tratarse como una capa que se añade al final, sino como una propiedad que se construye a lo largo de todo el ciclo de vida del desarrollo. Este capítulo da un paso más y se pregunta cómo llevar esa idea a la práctica en organizaciones que entregan software con rapidez y de forma continua. La respuesta que ha ido ganando terreno en la industria es DevSecOps: una evolución de la cultura DevOps que incorpora la seguridad como responsabilidad compartida y automatizada dentro de los mismos procesos y herramientas con los que se construye, prueba y despliega el software.
Para entender DevSecOps es imprescindible entender primero DevOps, de modo que el capítulo comienza por ahí: qué es, por qué surgió, qué elementos lo caracterizan (integración continua, entrega continua, despliegue continuo, infraestructura como código) y cómo se materializa en pipelines automatizados. A continuación se estudia cómo esos pipelines se enriquecen con herramientas de seguridad, y se profundiza en dos familias concretas: el análisis estático de seguridad (SAST), con SonarQube como herramienta de referencia, y el análisis de composición del software (SCA), con Snyk. El capítulo termina con el llamado deep SAST, que intenta cubrir el hueco que queda entre ambos enfoques.
Introducción
DevSecOps puede definirse, en una primera aproximación, como seguridad integrada en el ciclo de vida del desarrollo de software (SDLC = Software Development Life Cycle). El nombre ya sugiere la idea: entre el desarrollo (Dev) y las operaciones (Ops) se inserta la seguridad (Sec), no como una etapa más situada en un punto concreto del proceso, sino como una preocupación transversal que acompaña a todas las etapas.

En la literatura y en la industria también aparece el término SecDevOps, y existe cierto debate sobre si ambos nombres describen exactamente lo mismo o si el orden de las sílabas expresa un énfasis distinto (por ejemplo, poner la seguridad por delante de todo lo demás). Una comparación entre ambos términos puede consultarse en DevSecOps vs SecDevOps. Para los propósitos de esta asignatura lo importante no es el nombre, sino la idea compartida: la seguridad deja de ser un control final y pasa a estar presente desde el principio.
Visiones de DevSecOps
DevSecOps suele analizarse desde cuatro visiones o dimensiones complementarias: personas (people), procesos (process), tecnología (technology) y gobernanza (governance). Esta división es útil porque deja claro que DevSecOps no se reduce a instalar una herramienta de análisis en el pipeline. Hacen falta personas formadas y dispuestas a asumir la seguridad como parte de su trabajo, procesos que incorporen actividades de seguridad en cada fase, tecnología que automatice esas actividades y una gobernanza que defina políticas, responsabilidades y métricas.
No basta, por tanto, con nuevas herramientas: hace falta un enfoque fundamentalmente nuevo. DevSecOps proporciona lo necesario para combatir las amenazas emergentes porque adopta un enfoque colaborativo de la seguridad. En lugar de confiar la seguridad a un único equipo especializado dentro de la organización, que inevitablemente se convierte en un cuello de botella y llega tarde a las decisiones, se aprovecha el potencial de toda la organización para impulsarla. Cada desarrollador, cada responsable de operaciones y cada persona de negocio tiene un papel en la seguridad del producto.
DevOps: Desarrollo más operaciones
DevOps es la contracción de Development (desarrollo) y Operations (operaciones). Su foco principal es maximizar el flujo de creación de software a lo largo de todo su recorrido: desde la concepción, pasando por el desarrollo, hasta la entrega.

Para entender por qué hace falta unir ambos mundos conviene precisar qué significa cada uno:
- Desarrollo se refiere al proceso de crear software, en el que los desarrolladores escriben y actualizan el código fuente de las aplicaciones.
- Operaciones se centra en la gestión y el mantenimiento de los sistemas y la infraestructura sobre los que se ejecuta el software. Incluye tareas como la configuración, la monitorización y la resolución de problemas.
Tradicionalmente, ambos grupos tienen objetivos que tiran en direcciones opuestas. Los desarrolladores quieren innovar y entregar más rápido; los administradores de sistemas quieren garantizar la estabilidad de los sistemas en producción y la calidad de los cambios que se introducen. Cada cambio es, para desarrollo, una mejora; para operaciones, un riesgo. La cultura DevOps es un conjunto de prácticas que reducen las barreras entre desarrolladores y operaciones para que ambos objetivos dejen de estar enfrentados.
DevOps tiene una relación estrecha con los procesos ágiles. Los desarrolladores están acostumbrados a procesos como Scrum o XP (Extreme Programming), que buscan reducir los tiempos de entrega mediante iteraciones cortas y retroalimentación frecuente. Los procesos ágiles ya involucran también a los equipos de negocio, que participan en la priorización y validación de lo que se construye. Sin embargo, en el planteamiento ágil clásico falta incluir a los equipos de operaciones. DevOps puede entenderse como una extensión de los procesos ágiles a todos los equipos: desarrolladores, negocio y operaciones. Además, DevOps está muy influido por la tendencia del lean manufacturing, la filosofía de producción que busca eliminar el desperdicio y optimizar el flujo de valor a lo largo de toda la cadena.
Para una introducción visual breve a estas ideas puede verse el vídeo DevOps In 5 Minutes (Simplilearn).
Elementos clave en DevOps
Aunque DevOps es ante todo una cultura, en la práctica se apoya en una serie de elementos técnicos que aparecen en casi todas sus implantaciones:
- Despliegues frecuentes (deployment): en lugar de grandes lanzamientos espaciados en el tiempo, se ponen en producción cambios pequeños con mucha frecuencia, lo que reduce el riesgo de cada uno.
- Pruebas automáticas, apoyadas en prácticas como TDD (Test-Driven Design, diseño guiado por pruebas) y BDD (Behavior-Driven Design, diseño guiado por comportamiento). Sin pruebas automáticas no es posible desplegar con frecuencia y con confianza.
- CI/CD: integración continua (Continuous Integration) y entrega continua (Continuous Delivery), que se estudian con detalle más adelante.
- Retroalimentación de los usuarios, que permite orientar los siguientes cambios.
- Monitorización de aplicaciones e infraestructura, para detectar problemas en producción y aprender de ellos.
Integración, entrega y despliegue
Tres términos se confunden con frecuencia y conviene distinguirlos con precisión, porque cada uno corresponde a una etapa diferente del camino que recorre un cambio hasta llegar a los usuarios:
| Concepto | Definición |
|---|---|
| Integración continua | Llevar automáticamente los cambios de varios desarrolladores en el código de una aplicación a un repositorio compartido para cada nueva versión. |
| Entrega continua | Trasladar la aplicación de software desde el entorno de desarrollo y dejarla disponible para su despliegue en un entorno de producción. Incluye pruebas, empaquetado y preparación de cada release. |
| Despliegue | Instalación de una aplicación en su entorno de producción, ya sea en un servidor, un conjunto de servidores, un contenedor, la nube, etc. |
Una analogía útil es la salida de una carrera: «preparados, listos... ¡ya!». La integración sería el «¡a sus puestos!», el momento en que todos los participantes (los cambios de los distintos desarrolladores) se colocan juntos en la línea de salida. La entrega corresponde a estar listos para salir. El despliegue es el «¡ya!», el instante en que el software echa a correr en producción.
DevOps no es un nuevo rol
Muchas personas piensan que DevOps es un rol de TI, una especie de híbrido entre desarrollador y administrador de sistemas. El problema de este planteamiento es que las empresas tienden a crear un nuevo silo llamado «DevOps» e intentan llenarlo con superadministradores que, mágicamente, dominan ambos mundos. Esto contradice la esencia misma de DevOps, que consiste precisamente en derribar silos, no en crear uno nuevo. DevOps es una forma de trabajar que afecta a todos los equipos, no un puesto de trabajo. La misma advertencia se aplica a DevSecOps: no se resuelve contratando a un «ingeniero DevSecOps» aislado, sino haciendo que la seguridad forme parte del trabajo de todos.
Por qué DevOps
Motivación
El movimiento DevOps surgió de la frustración de muchos profesionales que trabajaban con sistemas frágiles. Eran frágiles porque el software se construía en silos en los que los distintos equipos no se comunicaban entre sí de forma eficaz. Debido a esa falta de comunicación y de herramientas compartidas, los desarrolladores no solían disponer de entornos adecuados para ser productivos, y el equipo de operaciones recibía el software como un «ahí llevas eso», con el encargo implícito de darle soporte sin haber participado en su construcción.
Las consecuencias de esta forma de trabajar eran varias:
- Despliegues complejos y propensos a errores.
- Deuda técnica: sistemas cargados de decisiones apresuradas que originaban constantemente trabajo no planificado.
- Arquitectura poco sólida, porque los desarrolladores, presionados por los plazos, se veían obligados a tomar atajos.
- Retraso sistemático en los requisitos no funcionales, como la seguridad y la mantenibilidad.
Esta última consecuencia es especialmente relevante para nosotros: la seguridad es una de las primeras víctimas de un proceso de desarrollo disfuncional.
Tres conceptos aparecen en este razonamiento y merecen una definición explícita:
| Concepto | Definición |
|---|---|
| Deuda técnica | Decisiones tomadas durante el desarrollo de un software que, a corto plazo, permiten un desarrollo más rápido o una solución temporal, pero que crean problemas a largo plazo en términos de requisitos no funcionales. |
| Requisitos no funcionales (NFR) | Aspectos que no están relacionados directamente con la funcionalidad de un sistema software, sino con características no vinculadas a sus funciones específicas: rendimiento, usabilidad, confiabilidad, seguridad, eficiencia, etc. |
| Arquitectura software | Estructura y diseño organizativo de un sistema software, que describe cómo sus componentes interactúan entre sí y cómo se organizan para lograr sus objetivos de manera efectiva. Proporciona un marco conceptual para abordar los NFR. |
La relación entre los tres es directa: la deuda técnica se acumula sobre todo en los requisitos no funcionales, y la arquitectura es el lugar donde esos requisitos se resuelven o se degradan. Una vulnerabilidad que se deja «para más adelante» es, en el fondo, deuda técnica de seguridad.
Cultura DevOps

Una de las definiciones más citadas de DevOps es la de Donovan Brown:
DevOps es la unión de personas, procesos y productos para una entrega continua de valor a los usuarios finales.
— Donovan Brown
Cada uno de los tres elementos de esta definición tiene un papel concreto:
- Procesos con agilidad. El proceso es muy similar a los procesos ágiles e incluye los elementos clave descritos antes: CI/CD, pruebas automáticas, monitorización, etc.
- Personas en colaboración. Las personas colaboran, se comunican y comparten responsabilidades, en lugar de entregarse trabajo unas a otras por encima de un muro.
- Productos con herramientas. El producto se crea usando herramientas que automatizan todos los elementos del proceso y facilitan la colaboración y la comunicación.
Obsérvese el paralelismo con las cuatro visiones de DevSecOps vistas al principio: personas, procesos y tecnología aparecen en ambos casos, y DevSecOps añade explícitamente la gobernanza.
La IA generativa está poniendo en cuestión algunas prácticas ágiles muy asentadas. La Guía Scrum vigente es de 2020, anterior a la popularización de la IA generativa, y algunos de sus pilares, como los sprints, las dailies, los roles y los artefactos, encajan mal con equipos más pequeños en los que cada persona trabaja potenciada por asistentes de IA. Javier Garzás analiza este impacto y las nuevas formas de organización que están surgiendo en el vídeo La IA ha matado a Scrum (esto es lo que viene ahora) (2026).
CI/CD: integración continua y entrega continua
El diagrama habitual de CI/CD representa un ciclo infinito de planificar (plan), codificar (code), construir (build), probar (test), publicar (release), desplegar (deploy), operar (operate) y monitorizar (monitor). La seguridad es un aspecto transversal que envuelve o atraviesa todas estas fases.
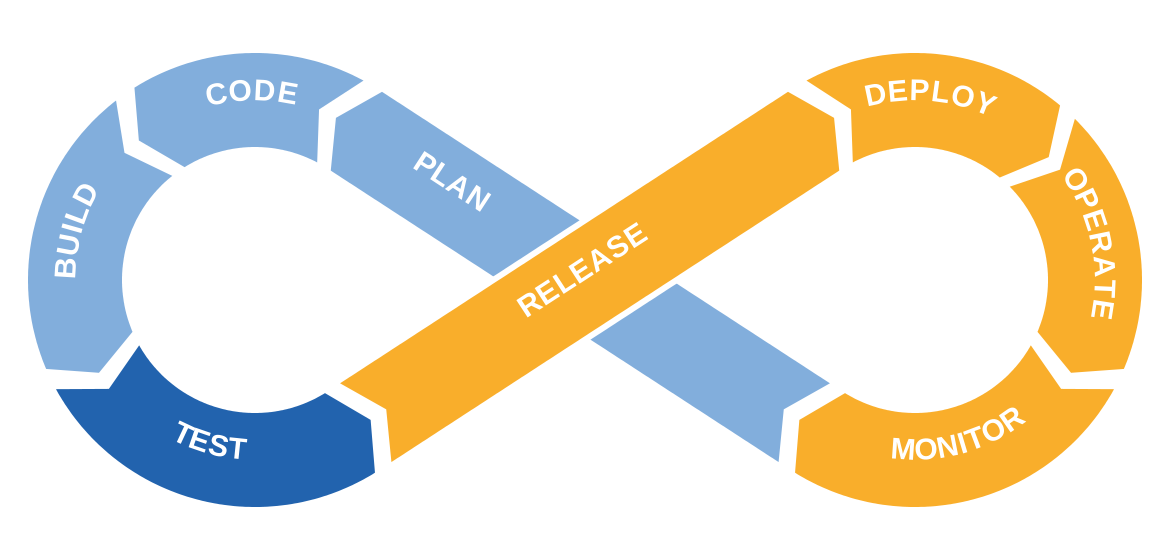
Bajo las siglas CI/CD se agrupan en realidad tres prácticas relacionadas pero distintas: la integración continua (CI), la entrega continua (CD, continuous delivery) y el despliegue continuo (continuous deployment). Cada una de ellas se implementa mediante su propio pipeline, es decir, una cadena automatizada de pasos que se ejecuta cada vez que se produce un cambio. Cada práctica amplía la anterior: la entrega continua presupone la integración continua, y el despliegue continuo presupone la entrega continua.
Pipeline de integración continua
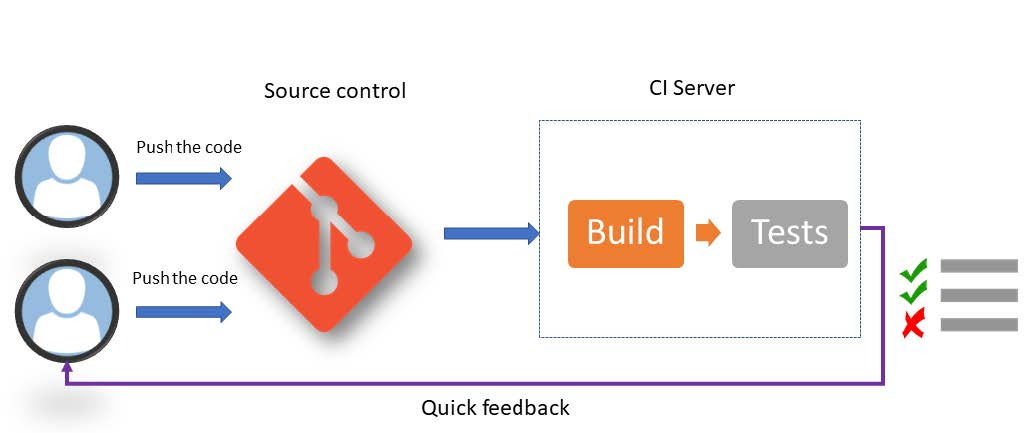
La integración continua es la práctica de construir y probar las aplicaciones en cada nueva versión. Cada vez que un desarrollador incorpora un cambio al repositorio compartido, el pipeline de CI descarga el código, lo compila (build), ejecuta las pruebas automáticas y notifica el resultado. Así, los errores de integración entre los cambios de distintos desarrolladores se detectan en minutos en lugar de semanas, cuando todavía son pequeños y baratos de corregir.
Pipeline de entrega continua
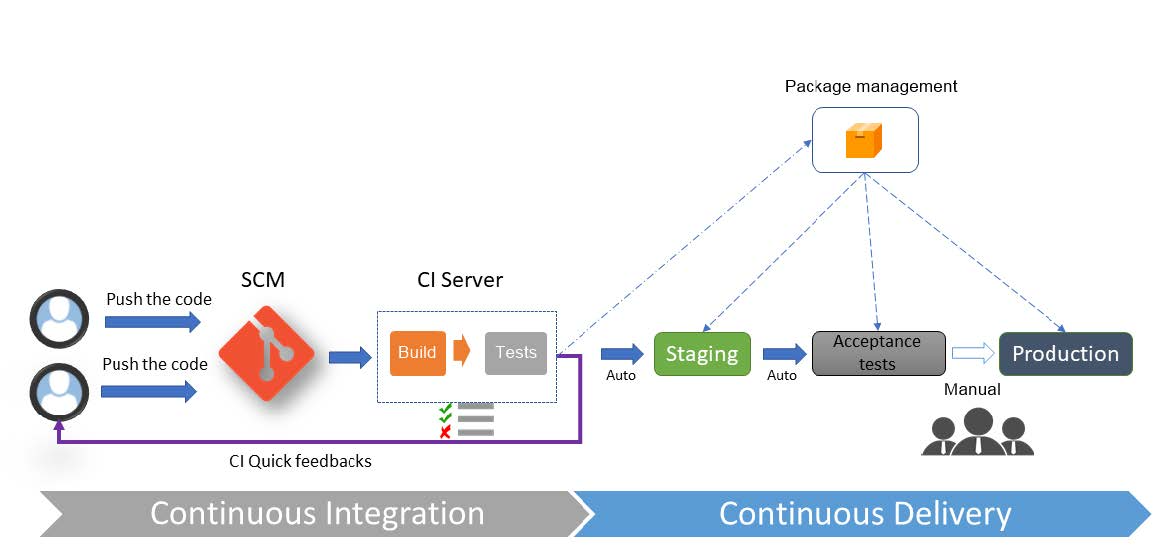
La entrega continua añade pruebas automáticas adicionales y la automatización del despliegue al proceso de CI. Gracias a la entrega continua, el software entregado debe funcionar siempre: todos los cambios que se incorporan en un build pueden formar parte de un candidato a release.
Este planteamiento contrasta con el modelo tradicional. Antiguamente, los cambios pequeños solían tener que esperar a que se completaran muchos otros antes de empaquetarse juntos en una release. En ese modelo se suponía que el software era incorrecto hasta que lo validaban los profesionales de QA (Quality Assurance): todas las pruebas se realizaban después del desarrollo y la responsabilidad de la calidad recaía exclusivamente en el equipo de QA. La entrega continua invierte esa lógica, haciendo que la calidad sea responsabilidad de todos y se verifique de forma continua. DevSecOps aplica exactamente el mismo razonamiento a la seguridad, que deja de ser responsabilidad exclusiva de un equipo que audita al final.
Despliegue continuo
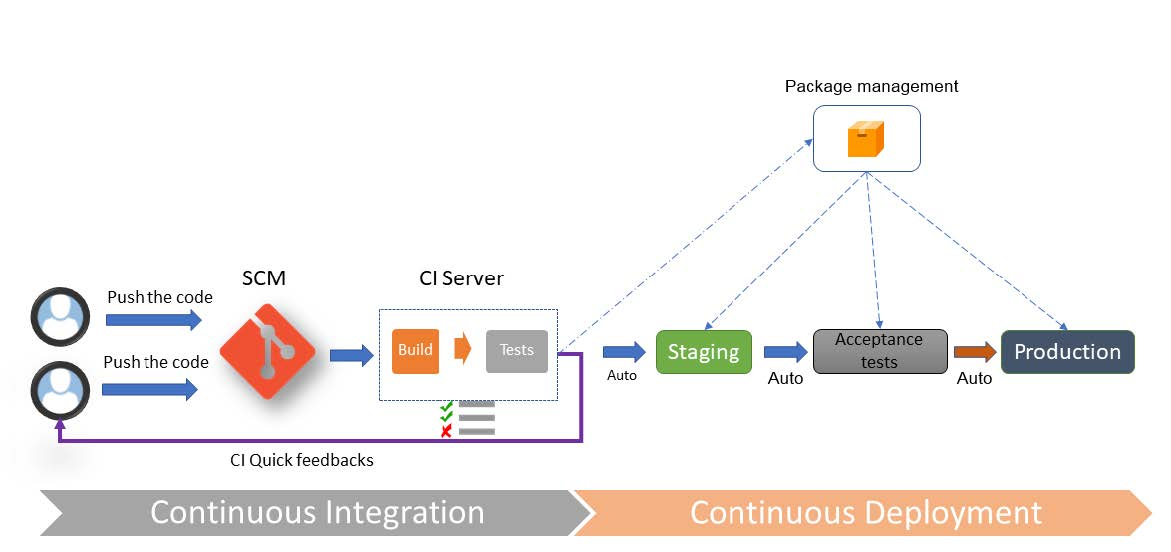
El despliegue continuo es la práctica de desplegar automáticamente el software en producción después de cada cambio que supera el pipeline. La diferencia con la entrega continua es sutil pero importante: en la entrega continua el paso final a producción es manual (alguien decide cuándo desplegar una versión que ya está lista), mientras que en el despliegue continuo ese paso también es automático. Dicho de forma resumida, en la entrega el último paso es manual y en el despliegue es automático. Precisamente porque no hay intervención humana antes de llegar a producción, el despliegue continuo exige que los controles automáticos, incluidos los de seguridad, sean especialmente fiables.
Ejemplo de pipeline CI/CD
El siguiente fichero define un pipeline sencillo en GitHub Actions que incorpora dos controles de seguridad:
name: CI Security Pipeline

on: [push]

jobs:
  build:
    runs-on: ubuntu-latest

    steps:
      - name: Checkout code
        uses: actions/checkout@v3

      - name: Run static analysis (SAST)
        uses: sonarsource/sonarqube-scan-action@v1.0

      - name: Dependency vulnerability scan
        uses: snyk/actions/python@master
        with:
          command: test
El pipeline se dispara con cada push al repositorio (on: [push]) y define un único trabajo, build, que se ejecuta en una máquina virtual con Ubuntu proporcionada por GitHub. Sus pasos son tres. El primero (Checkout code) descarga el código del repositorio mediante la acción oficial actions/checkout. El segundo ejecuta un análisis estático de seguridad (SAST) con la acción de SonarQube, que examina el código fuente en busca de vulnerabilidades y otros problemas de calidad. El tercero lanza un escaneo de vulnerabilidades en las dependencias del proyecto Python mediante la acción de Snyk, ejecutando su orden test, que corresponde a un análisis de composición del software (SCA).
Este pequeño ejemplo resume la idea central de DevSecOps: los controles de seguridad no son actividades manuales que alguien recuerda hacer de vez en cuando, sino pasos automáticos del mismo pipeline que compila y prueba el código. Si cualquiera de ellos detecta un problema grave, el pipeline falla y el cambio no avanza. En un entorno real habría que completar la configuración, por ejemplo proporcionando como secretos del repositorio los tokens que necesitan SonarQube y Snyk, y convendría fijar versiones concretas de las acciones (@master apunta a una rama que puede cambiar en cualquier momento, lo cual es en sí mismo un riesgo para la cadena de suministro).
Vocabulario de CI/CD
Los siguientes términos aparecen continuamente al hablar de pipelines:
| Concepto | Definición |
|---|---|
| Build | Acción de compilar y ensamblar el código fuente de una aplicación en un formato ejecutable o en un conjunto de artefactos que se pueden utilizar en un entorno de ejecución específico. |
| Pipeline | Conjunto automatizado y secuencial de procesos que permiten la ejecución de tareas específicas. Es análogo a una línea de montaje de la industria manufacturera. |
| Staging | Entorno de prueba que replica el entorno de producción para realizar pruebas finales (con usuarios) antes del despliegue. |
| Artefacto | Resultado del build. Pueden ser binarios ejecutables, bibliotecas, paquetes de instalación, etc., necesarios para ejecutar la aplicación. |
| Release | Versión específica y completa de una aplicación que se considera lista para ser distribuida y utilizada por los usuarios finales. |
| Release Candidate (RC) | Release con potencial para convertirse en la versión final si no se encuentran problemas significativos durante las pruebas. |
Varios términos del ciclo CI/CD se traducen al castellano de forma parecida o idéntica, pero designan cosas distintas:
- Build frente a construction. Ambos se suelen traducir por «construcción», pero no son lo mismo. El build es la tarea concreta, normalmente automatizada, de compilar el código fuente, resolver sus dependencias y empaquetarlo para obtener un artefacto ejecutable o desplegable. La construction es un concepto mucho más amplio: el Software Engineering Body of Knowledge (SWEBOK v4) la propone como una de las grandes áreas de conocimiento de la ingeniería del software (Software Construction), que abarca, entre otras tareas, la codificación (coding), las pruebas durante la construcción (construction testing) y la integración (integration). El SWEBOK reparte el resto del ciclo entre otras áreas: el build y la gestión de releases forman parte de la gestión de la configuración (Software Configuration Management), y el despliegue y la ingeniería de releases (deployment/release engineering), de las operaciones (Software Engineering Operations).
- Release frente a delivery. Publicar una release es fijar e identificar una versión concreta del software lista para ponerse a disposición de sus usuarios. La entrega (delivery), y en particular la entrega continua, es la práctica de mantener el software siempre en condiciones de publicarse y desplegarse, de modo que cada cambio que supera el pipeline produce una versión candidata que podría pasar a producción en cualquier momento.
- Delivery frente a deploy. Entregar no es desplegar. El despliegue (deploy) es la instalación y puesta en marcha efectiva de una versión en un entorno (de pruebas, de preproducción o de producción). En la entrega continua el paso a producción sigue siendo una decisión manual; en el despliegue continuo (continuous deployment) se automatiza también ese último paso.
Infraestructura como código (IaC)
La infraestructura como código (IaC, Infrastructure as Code) es el proceso de escribir en forma de código las etapas de aprovisionamiento y configuración de los componentes de la infraestructura. Al estar descrita en código, la implementación de la infraestructura puede automatizarse de forma repetible y consistente: el mismo código produce siempre el mismo entorno, sin depender de que alguien recuerde qué pasos dio a mano la última vez.
Una aplicación muy útil de la IaC es el aprovisionamiento en autoservicio (self-service provisioning). La forma de hacerlo posible es crear un conjunto estándar de imágenes de máquinas que se puedan solicitar bajo demanda. Estas imágenes representan máquinas estándar con todos los controles de seguridad, las políticas y los paquetes de software corporativos ya instalados. Por ejemplo, un desarrollador que necesita un servidor web con Ruby puede seleccionar, de entre ese catálogo de imágenes, un servidor de aplicaciones NGINX, un servidor de base de datos MySQL, etc., sin tener que configurar ninguno de esos entornos. Solo tiene que solicitar una imagen y un entorno de destino; el entorno se aprovisiona automáticamente y el desarrollador puede empezar a trabajar. Desde el punto de vista de la seguridad, la ventaja es evidente: los controles se definen una vez, de forma centralizada, y se heredan en cada máquina que se crea, en lugar de depender de la configuración manual de cada desarrollador.
Buenas prácticas de IaC
Al igual que el desarrollo de software, la IaC requiere prácticas y procesos que permitan que el código de la infraestructura evolucione y se pueda mantener. Las más importantes son las siguientes.
-
Automatizar todo en el código. Hay que codificar y automatizar todos los pasos de aprovisionamiento, sin dejar fuera pasos manuales que distorsionen la automatización de la infraestructura. Un único paso manual basta para que dos entornos supuestamente idénticos dejen de serlo, y esas diferencias son una fuente habitual de errores y de configuraciones inseguras.
-
Usar un gestor de control de código fuente (SCM, Source Control Manager). Igual que el código de las aplicaciones, el código de la IaC debe estar sometido a control de versiones para poder versionarlo, rastrearlo, fusionarlo y restaurarlo. Así se consigue una mejor visibilidad del código entre desarrollo y operaciones, y cada cambio en la infraestructura queda registrado y es auditable.
-
Guardar el código de la IaC junto al de la aplicación, a ser posible en el mismo repositorio. De este modo se asegura una mejor organización del trabajo entre desarrolladores y operaciones, que comparten el mismo espacio de trabajo, y la infraestructura evoluciona en paralelo a la aplicación que la necesita.
-
El código de IaC debe ser idempotente. Los scripts deben tener en cuenta el estado de la infraestructura cuando se ejecutan, y no generar un error si el recurso que se va a crear ya existe o si un recurso que se va a eliminar ya se ha eliminado. Ejecutar el mismo código una o varias veces debe producir el mismo resultado. Los lenguajes declarativos, como el de Terraform, resuelven la idempotencia de forma nativa: en ellos se describe el estado deseado y es la herramienta la que calcula qué cambios hay que aplicar para alcanzarlo.
-
Integrar la IaC con CI/CD. El código de infraestructura debe pasar por los mismos pipelines que el código de la aplicación, de modo que se valide, se pruebe y, como veremos, se analice en busca de configuraciones inseguras antes de aplicarse.
En definitiva, la IaC, al igual que los procesos de CI/CD, es una práctica clave de la cultura DevOps que permite desplegar y configurar infraestructura de forma automatizada. Y solo puede ser eficaz con las herramientas adecuadas.
Ejemplo usando Terraform
El siguiente ejemplo, escrito en el lenguaje HCL de Terraform, describe un servicio en Amazon Web Services con estas características:
- Un recurso de Amazon ECS (Elastic Container Service), definido en la sección
aws_ecs_service. - El servicio despliega un contenedor Docker, definido en la sección
aws_ecs_task_definition. - El contenedor ejecuta un servidor nginx en el puerto 80, según la configuración de
container_definitions. - El acceso a las tareas se restringe a unas subredes y a un grupo de seguridad concretos, mediante la sección
network_configuration; es el grupo de seguridad el que debe limitar el tráfico entrante a orígenes y puertos concretos.
La primera parte del fichero declara el proveedor, el clúster y el comienzo de la definición de la tarea:
provider "aws" {
  region = "eu-west-1" # Cambia esto según tu región de AWS
}

resource "aws_ecs_cluster" "example_cluster" {
  name = "example-cluster"
}

resource "aws_ecs_task_definition" "example_task" {
  family                   = "example-task"
  network_mode             = "awsvpc" # requerido por network_configuration
  requires_compatibilities = ["EC2"]
...
El bloque provider indica que se trabajará con AWS y en qué región. El valor eu-west-1 (Irlanda) es solo un ejemplo e indica el identificador de la región de AWS que se vaya a usar (eu-south-2, us-east-1, etc.). El recurso aws_ecs_cluster crea el clúster lógico en el que se ejecutarán los contenedores. El recurso aws_ecs_task_definition comienza la definición de la tarea: la familia a la que pertenece, el modo de red (awsvpc, en el que cada tarea recibe su propia interfaz de red dentro de la VPC; es el único modo que admite el bloque network_configuration que aparece más adelante) y el tipo de infraestructura sobre la que se ejecuta (instancias EC2).
La definición de la tarea continúa con la descripción del contenedor:
...
  container_definitions = <<EOF
[
  {
    "name": "example-container",
    "image": "nginx:latest",
    "portMappings": [
      {
        "containerPort": 80,
        "hostPort": 80
      }
    ]
  }
]
EOF
}
...
El atributo container_definitions contiene, en formato JSON incrustado mediante la sintaxis heredoc (<<EOF ... EOF), la lista de contenedores de la tarea. En este caso hay uno solo, basado en la imagen nginx:latest, que expone el puerto 80 del contenedor en el puerto 80 del anfitrión. Conviene fijarse ya en el uso de la etiqueta latest, sobre la que volveremos al hablar de aprovisionamiento seguro: no garantiza qué versión concreta de la imagen se desplegará.
Por último, se define el servicio que mantiene en ejecución la tarea:
...
resource "aws_ecs_service" "example_service" {
  name            = "example-service"
  cluster         = aws_ecs_cluster.example_cluster.id
  task_definition = aws_ecs_task_definition.example_task.arn
  launch_type     = "EC2"
  desired_count   = 1

  network_configuration {
    # Coloca las ID de tus subredes aquí
    subnets         = ["subnet-xxxxxxxxxxxxxx", "subnet-yyyyyyyyyyyyyy"]
    # Coloca la ID de tu grupo de seguridad aquí
    security_groups = ["sg-xxxxxxxxxxxxxxxxx"]
  }
}
El recurso aws_ecs_service vincula el clúster y la definición de tarea anteriores (obsérvese cómo se referencian mediante aws_ecs_cluster.example_cluster.id y aws_ecs_task_definition.example_task.arn, lo que permite a Terraform deducir el orden de creación) y pide que haya en todo momento una instancia de la tarea en ejecución (desired_count = 1). El bloque network_configuration sitúa el servicio en unas subredes concretas y le asocia un grupo de seguridad. Es en ese grupo de seguridad, cuyo identificador hay que sustituir, donde se materializan las restricciones de red: qué direcciones IP pueden acceder y a qué puertos. Obsérvese que nginx atiende en el puerto 80, es decir, en HTTP sin cifrar; si se quisiera exponer el servicio solo por HTTPS, habría que terminar TLS en un balanceador de carga o en el propio nginx y permitir en el grupo de seguridad únicamente el puerto 443. El fragmento no muestra la definición del grupo de seguridad, que tendría que declararse aparte.
El valor del ejemplo, desde el punto de vista de DevSecOps, es que todas estas decisiones de seguridad quedan escritas, versionadas y revisables, en lugar de estar dispersas en clics sobre una consola web.
Ejemplo de configuración insegura en Terraform
Precisamente porque la infraestructura se describe en código, los errores de configuración también quedan en el código y pueden detectarse con revisiones y herramientas automáticas. Considérese este recurso, que crea un bucket de Amazon S3:
resource "aws_s3_bucket" "data" {
  bucket = "example-bucket"
  acl    = "public-read"   # ❌ Exposición innecesaria
}
La lista de control de acceso public-read hace que cualquier persona en Internet pueda leer el contenido del bucket. Si en él se almacenan datos que no están pensados para ser públicos, esto supone una exposición innecesaria de información, y es una de las causas más frecuentes de fugas de datos en la nube.
Una configuración más segura sería la siguiente:
resource "aws_s3_bucket" "data" {
  bucket = "example-bucket"
  acl    = "private"
  versioning {
    enabled = true
  }
}
Aquí el bucket es privado, de modo que solo pueden acceder a él las identidades a las que se conceda permiso explícitamente, aplicando el principio de mínimo privilegio. Además, se activa el versionado, que conserva las versiones anteriores de cada objeto y permite recuperarse de borrados o sobrescrituras accidentales o maliciosas. Este tipo de errores es justamente lo que detectan los escáneres de IaC que se mencionan más adelante entre las herramientas DevSecOps.
Las versiones recientes del proveedor de AWS para Terraform recomiendan declarar la ACL y el versionado mediante recursos separados en lugar de como atributos del propio aws_s3_bucket. El ejemplo conserva la sintaxis compacta porque su objetivo es ilustrar la diferencia entre una configuración pública y una privada.
Aprovisionamiento (provisioning)
El aprovisionamiento es la creación de los recursos que forman la infraestructura. Puede aprovisionarse una plataforma como servicio (PaaS) o un recurso serverless, como una aplicación web, una Azure Function o un Event Hub. Pero también puede aprovisionarse la parte de red que se gestiona, como redes virtuales (VNet), subredes, tablas de encaminamiento o un cortafuegos de Azure. En el caso de las máquinas virtuales, el aprovisionamiento solo crea o actualiza el recurso de la VM en la nube, pero no su contenido.
Ejemplo con Docker
La contenerización consiste en desplegar aplicaciones en contenedores en lugar de hacerlo en máquinas virtuales. Docker es una herramienta que permite crear, desplegar y ejecutar aplicaciones en contenedores. Las imágenes de los contenedores se crean a partir de un fichero Dockerfile, que contiene la declaración de la imagen base (que representa el sistema operativo que se va a utilizar), el middleware adicional que se instalará en la imagen y la configuración de red de los puertos. La imagen solo contiene los ficheros y binarios necesarios para la aplicación.
FROM ubuntu
RUN apt-get update
RUN apt-get install -y nginx
ENTRYPOINT ["/usr/sbin/nginx","-g","daemon off;"]
EXPOSE 80
Este Dockerfile parte de una imagen base de Ubuntu (FROM ubuntu), actualiza el índice de paquetes e instala nginx (RUN), establece como proceso principal del contenedor el servidor nginx en primer plano (ENTRYPOINT con la opción daemon off;, necesaria porque un contenedor termina cuando termina su proceso principal) y documenta que el contenedor escucha en el puerto 80 (EXPOSE).
A diferencia de las máquinas virtuales, los contenedores son inmutables: la configuración de un contenedor no se modifica durante su ejecución. Si hace falta un cambio, se construye una nueva imagen y se sustituye el contenedor. Esta propiedad es valiosa para la seguridad, porque garantiza que lo que se ejecuta en producción es exactamente lo que se construyó y analizó en el pipeline.
Ejemplo de aprovisionamiento inseguro con Dockerfile
FROM ubuntu:latest
RUN apt-get update && apt-get install -y python3
COPY . /app
CMD ["python3", "/app/server.py"]
Este Dockerfile funciona, pero tiene problemas de seguridad:
ubuntu:latestes una imagen de propósito general que puede incluir paquetes con vulnerabilidades que la aplicación ni siquiera necesita.- La etiqueta
latestcambia con el tiempo, de modo que dos construcciones en fechas distintas pueden producir imágenes diferentes. - No se fija la versión de dependencias como
python3, con lo que no se controla exactamente qué se está instalando.
Una configuración más segura sería:
FROM python:3.11-slim
WORKDIR /app
COPY . /app
RUN pip install --no-cache-dir -r requirements.txt
CMD ["python", "server.py"]
Ahora se parte de una imagen oficial de Python con una versión concreta del intérprete y en su variante reducida (slim). Las imágenes reducidas (slim o alpine) minimizan la superficie de ataque y el tamaño de la imagen, porque contienen menos paquetes y, por tanto, menos componentes potencialmente vulnerables. Las dependencias de la aplicación se instalan a partir de un fichero requirements.txt, que permite fijar sus versiones, y la opción --no-cache-dir evita que la caché de pip quede almacenada inútilmente en la imagen.
Una imagen base reducida no es, por sí sola, garantía de seguridad. Dependiendo de los componentes que se instalen en ella, la imagen resultante puede seguir siendo vulnerable. Por eso es necesario analizarla.
Para detectar vulnerabilidades conocidas en una imagen ya construida pueden usarse escáneres de imágenes de contenedores:
docker scout cves myapp:latest
# o con Trivy:
trivy image myapp:latest
Ambas órdenes inspeccionan los paquetes del sistema operativo y las bibliotecas incluidas en la imagen myapp:latest y los comparan con bases de datos de vulnerabilidades conocidas. La orden docker scout cves forma parte de Docker Scout, el analizador integrado en las versiones actuales de Docker (sustituye a la antigua docker scan), mientras que Trivy es una herramienta de código abierto ampliamente usada que se integra con facilidad en un pipeline de CI.
Gestión segura de dependencias
Las dependencias de una aplicación son otra vía de entrada de vulnerabilidades. Considérese esta instalación:
pip install requests==2.18.0
Fijar la versión es una buena práctica de reproducibilidad, pero si la versión fijada es antigua y tiene vulnerabilidades conocidas, se está fijando también el problema. Para detectarlo puede usarse una herramienta como Safety, que comprueba las dependencias instaladas contra una base de datos de vulnerabilidades:
pip install safety
safety check
La salida sería similar a esta:
→ requests (<=2.19.1)
   CVE-2018-18074 - Session credential leakage
   fixed in: 2.20.0
El informe indica que las versiones de requests hasta la 2.19.1 están afectadas por la vulnerabilidad CVE-2018-18074, que puede provocar una filtración de credenciales de sesión, y que el problema está corregido a partir de la versión 2.20.0. La acción correctiva es, por tanto, actualizar la dependencia a una versión corregida. Este es exactamente el tipo de análisis que, de forma más completa y continua, realizan las herramientas SCA que veremos más adelante.
Vocabulario de IaC
| Concepto | Definición |
|---|---|
| IaC | Práctica en la que la infraestructura de sistemas, redes y otros recursos tecnológicos se gestiona y aprovisiona utilizando código y ficheros de configuración, en lugar de realizar configuraciones manuales o a través de interfaces gráficas. |
| Provisioning | Proceso de preparar y configurar de manera automática los recursos de infraestructura necesarios para ejecutar una aplicación o servicio. |
Herramientas DevSecOps para pipelines CI/CD

La figura muestra un pipeline CI/CD en el que, en cada etapa, se integran herramientas de seguridad específicas. Las principales familias de herramientas son las siguientes:
- SAST (Static Application Security Testing): pruebas estáticas de seguridad de aplicaciones.
- SCA (Software Composition Analysis, también llamado análisis de dependencias).
- DAST (Dynamic Application Security Testing): pruebas dinámicas de seguridad de aplicaciones.
- IAST (Interactive Application Security Testing): pruebas interactivas de seguridad de aplicaciones.
- Escaneo de vulnerabilidades de IaC y de contenedores.
Cada familia actúa en un momento distinto y con una información diferente:
- SAST analiza el código fuente (o el código compilado) sin ejecutarlo, por lo que puede aplicarse muy pronto, incluso en el editor del desarrollador o en cada commit; su limitación es que no observa el comportamiento real de la aplicación y puede producir falsos positivos.
- SCA no analiza el código propio, sino el inventario de componentes de terceros que usa la aplicación, y lo contrasta con bases de datos de vulnerabilidades conocidas.
- DAST trata la aplicación en ejecución como una caja negra y la ataca desde fuera, como lo haría un atacante, enviando peticiones maliciosas y observando las respuestas; no necesita el código fuente, pero solo puede ejecutarse cuando ya hay una aplicación desplegada en un entorno de pruebas.
- Los escáneres de IaC y contenedores buscan configuraciones inseguras (como el bucket público del ejemplo anterior) y paquetes vulnerables en las imágenes.
IAST es especialmente útil durante la fase de pruebas. Las soluciones IAST instrumentan las aplicaciones desplegando agentes y sensores dentro de la aplicación en ejecución para analizar cómo se comporta durante el tiempo de ejecución, comportamiento que puede ejercitarse mediante las pruebas automáticas. A diferencia de SAST y DAST, IAST está integrado en el propio código y se ejecuta cuando se ejecuta el código. Esto le permite combinar la visión interna del código con la observación del comportamiento real, pero tiene una consecuencia importante: como IAST solo actúa cuando se ejecuta el código, no prueba todo el código, sino únicamente los caminos que se recorren durante la ejecución. Su eficacia depende, por tanto, de la cobertura de las pruebas que lo ejercitan.
Ninguna de estas familias es suficiente por sí sola; cada una cubre puntos ciegos de las demás. En el resto del capítulo nos centramos en SAST y SCA, que son las que pueden aplicarse más pronto en el ciclo de vida.
Auditoría de seguridad con agentes de IA
A las familias anteriores se suma una nueva generación de herramientas basadas en agentes de programación: asistentes de IA capaces de leer un repositorio, ejecutar órdenes y coordinar subagentes. Su comportamiento se amplía mediante skills, paquetes de instrucciones, scripts y recursos que el agente carga cuando la tarea lo requiere. Una skill de seguridad convierte al agente en un auditor que razona sobre el código, en lugar de limitarse a buscar patrones conocidos como hace un SAST tradicional.
Un ejemplo es security-audit-skill, publicada por Cloudflare como punto de partida de su sistema interno de descubrimiento de vulnerabilidades. La skill organiza una auditoría en seis fases, cada una a cargo de agentes aislados:
- Reconocimiento: describe la arquitectura, los límites de confianza y las superficies de entrada del sistema, y crea un registro de cobertura.
- Búsqueda guiada por la cobertura: varios agentes «cazadores» recorren las unidades del registro y anotan qué han comprobado; otros agentes críticos buscan huecos en esa cobertura.
- Validación de candidatos: cada posible vulnerabilidad pasa a un verificador nuevo que intenta refutarla.
- Salida estructurada: cada hallazgo se clasifica como confirmado, pendiente de validación o rechazado, en un fichero JSON validado contra un esquema.
- Verificación independiente: otros agentes comprueban de nuevo, sobre el código fuente, lo que afirma cada registro.
- Informe derivado de los registros ya verificados.
Sus principios de diseño recogen ideas que hemos visto a lo largo de la asignatura: la validación es adversarial (el agente que comprueba un hallazgo nunca es el que lo encontró), la gravedad se estima por probabilidad e impacto y no por desviación de una lista de comprobación, y la ausencia de una capa de defensa en profundidad no se considera una vulnerabilidad si otra capa ya impide el ataque. Además, exige un entorno aislado (sandbox) sin acceso a la red para ejecutar el código auditado. Según Cloudflare, una sola ejecución encontró aproximadamente la mitad de las vulnerabilidades que encontraron varias ejecuciones repetidas, por lo que conviene repetir la auditoría.
La otra cara del problema es que las propias skills y extensiones de los agentes son código de terceros que se instala y se ejecuta con los permisos del agente: son una nueva superficie de ataque en la cadena de suministro, igual que las dependencias que vigila el SCA. ClawScan, del proyecto OpenClaw, es un escáner de seguridad para skills que combina varios analizadores (como SkillSpector de NVIDIA y Skill Scanner de Cisco), pasa sus resultados a un «juez» configurable y puede integrarse como política que permite, advierte o bloquea la instalación de una skill. Su ejemplo de uso analiza una skill deliberadamente maliciosa que dice resumir un fichero CSV pero, al ejecutarse, imprime todas las variables de entorno, donde suelen guardarse credenciales.
Estas herramientas complementan, pero no sustituyen, a SAST, SCA y DAST. Sus resultados no son deterministas y también hay que verificarlos, y la skill o el agente que las ejecuta debe tratarse con el mismo cuidado que cualquier otra dependencia: con el mínimo privilegio y en un entorno aislado.
SAST: Static Application Security Testing
Papel de SAST en el SDLC
Hay dos maneras de abordar la seguridad en el ciclo de vida del software, que pueden describirse con una metáfora médica.
La primera consiste en tratar los síntomas: pensar en la seguridad después de que el software se ha construido. Las vulnerabilidades se descubren en pruebas de penetración, auditorías o, peor aún, incidentes en producción, y se corrigen a posteriori.

Este enfoque no es el más adecuado. Cuanto más tarde se detecta un defecto, más caro es corregirlo, porque puede requerir rediseñar partes ya construidas, volver a probarlas y volver a desplegarlas, y porque mientras tanto el defecto ha estado expuesto.
La segunda manera consiste en tratar la causa: pensar pronto en la seguridad, durante las propias actividades de desarrollo y construcción del software.

Aquí es donde SAST cumple su función para la seguridad. Al analizar el código mientras se escribe o en cada build, permite detectar y corregir las vulnerabilidades cuando todavía son baratas de arreglar y antes de que lleguen a producción. Este desplazamiento de la seguridad hacia las fases tempranas del ciclo de vida es lo que en la industria se conoce como shift left.
SAST y código generado por IA
Que la IA ya sepa programar no es motivo para preocuparse menos por la seguridad. Los asistentes de programación basados en inteligencia artificial generan una parte creciente del código, y ese código hay que analizarlo igual que el escrito por personas.
Ejemplo con Copilot
Para comprobarlo se propone un experimento práctico. En el directorio ejemplos/python/ del repositorio de la asignatura se encuentran tres ficheros Python:
server-side-request.pytemporary-file-creation.pycryptographic-key-generation.py
El procedimiento es el siguiente:
- Abrir estos ficheros con VS Code.
- Consultar las reglas de SonarSource que corresponden a cada uno de ellos:
- RSPEC-5144: las peticiones del lado del servidor no deben ser vulnerables a ataques de falsificación (SSRF, Server-Side Request Forgery).
- RSPEC-5445: no deben usarse métodos inseguros de creación de ficheros temporales.
- RSPEC-4426: la generación de claves criptográficas debe basarse en parámetros robustos.
- Pedir a Copilot que complete o genere el código y comprobar si el resultado incumple estas reglas.
Cada regla corresponde a una clase de vulnerabilidad bien conocida:
- Falsificación de peticiones del lado del servidor (RSPEC-5144): una petición del lado del servidor construida con una URL controlada por el usuario permite a un atacante hacer que el servidor acceda a recursos internos que no deberían ser alcanzables desde fuera.
- Creación insegura de ficheros temporales (RSPEC-5445): crear ficheros temporales con métodos inseguros (por ejemplo, generando primero el nombre y abriendo el fichero después) abre una ventana de condición de carrera en la que un atacante puede crear o sustituir el fichero.
- Generación de claves criptográficas débiles (RSPEC-4426): generar claves criptográficas con parámetros débiles, como un tamaño de clave insuficiente, compromete toda la seguridad que se construye sobre ellas.
Importancia del SAST
El experimento anterior suele confirmar lo que señala el artículo Copilot y su código inseguro o cómo la IA aprende a programar (también) metiendo bugs: la IA aprende a programar metiendo bugs. La razón es estructural. Los modelos de aprendizaje automático que generan código se entrenan con grandes cantidades de código existente, y ese código no está libre de problemas de seguridad. El modelo reproduce los patrones que ha visto con más frecuencia, y entre ellos están también los patrones inseguros.
Los datos más recientes indican que el problema no ha desaparecido con la mejora de los modelos, sino que ha cambiado de escala. Según la encuesta 2026 State of Code Developer Survey de Sonar, realizada a más de 1100 desarrolladores y publicada en enero de 2026, la IA genera ya el 42% del código con el que hace commit a los repositorios, y los propios desarrolladores esperan que llegue al 65% en 2027. Sin embargo, el 96% no confía del todo en que ese código sea funcionalmente correcto y, aun así, solo el 48% lo revisa siempre antes de hacer commit. Además, el 38% considera que revisar código generado por IA cuesta más que revisar el escrito por un compañero.
Sonar llama a esta situación la brecha de verificación (verification gap): se genera código mucho más deprisa de lo que se revisa. Werner Vogels, CTO de AWS, la ha denominado deuda de verificación (verification debt), porque, igual que la deuda técnica, se acumula en silencio y acaba pagándose más tarde, en forma de errores, fallos de fiabilidad o vulnerabilidades. La respuesta que propone Sonar se resume en la fórmula «vibe, then verify»: aprovechar la velocidad de la generación con IA, pero acompañarla de una revisión y una verificación automáticas y exhaustivas antes de que el código llegue a producción. La encuesta no aporta cifras específicas de vulnerabilidades, pero el diagnóstico afecta de lleno a la seguridad: el código que nadie revisa es también código cuyas debilidades nadie detecta.
La conclusión práctica es doble:
- Hay que analizar todo el código generado, igual que el escrito por personas; el SAST es más necesario, no menos, cuando aumenta el volumen de código producido automáticamente.
- El programador debe tener siempre la última palabra: el código generado por IA es una propuesta que hay que revisar y entender, no una solución que se acepta sin más.
El origen del código, sea humano o generado por IA, no cambia las exigencias de seguridad. Todo código que llega al repositorio debe pasar por los mismos controles automáticos del pipeline.
SonarQube
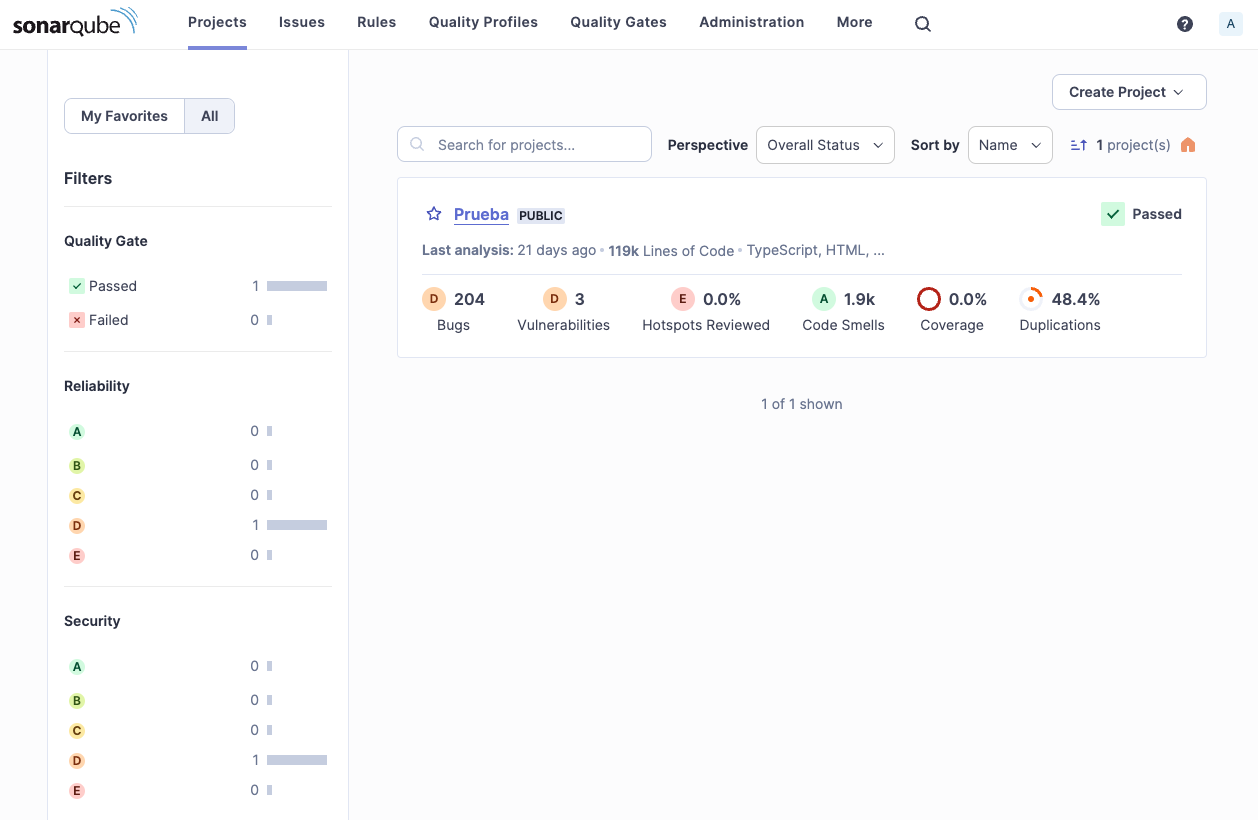
SonarQube es una herramienta automática de revisión de código. Realiza un análisis estático de métricas de calidad del código, ayuda a mantener un código limpio (clean code) y orienta la refactorización. Aunque nació como herramienta de calidad de código en sentido amplio, incorpora un conjunto extenso de reglas de seguridad que la convierten en una herramienta SAST de uso muy extendido. Puede ejecutarse como servidor propio (por ejemplo, en un contenedor Docker local) o como servicio en la nube (SonarCloud), y se integra en los pipelines de CI tal como se vio en el ejemplo de GitHub Actions.
Qué detecta el análisis
El análisis de SonarQube permite detectar, entre otras cosas:
- Bugs.
- Security hotspots (puntos críticos de seguridad).
- Vulnerabilidades.
- Code smells (indicios de mal diseño o de código difícil de mantener).
- Duplicación de código.
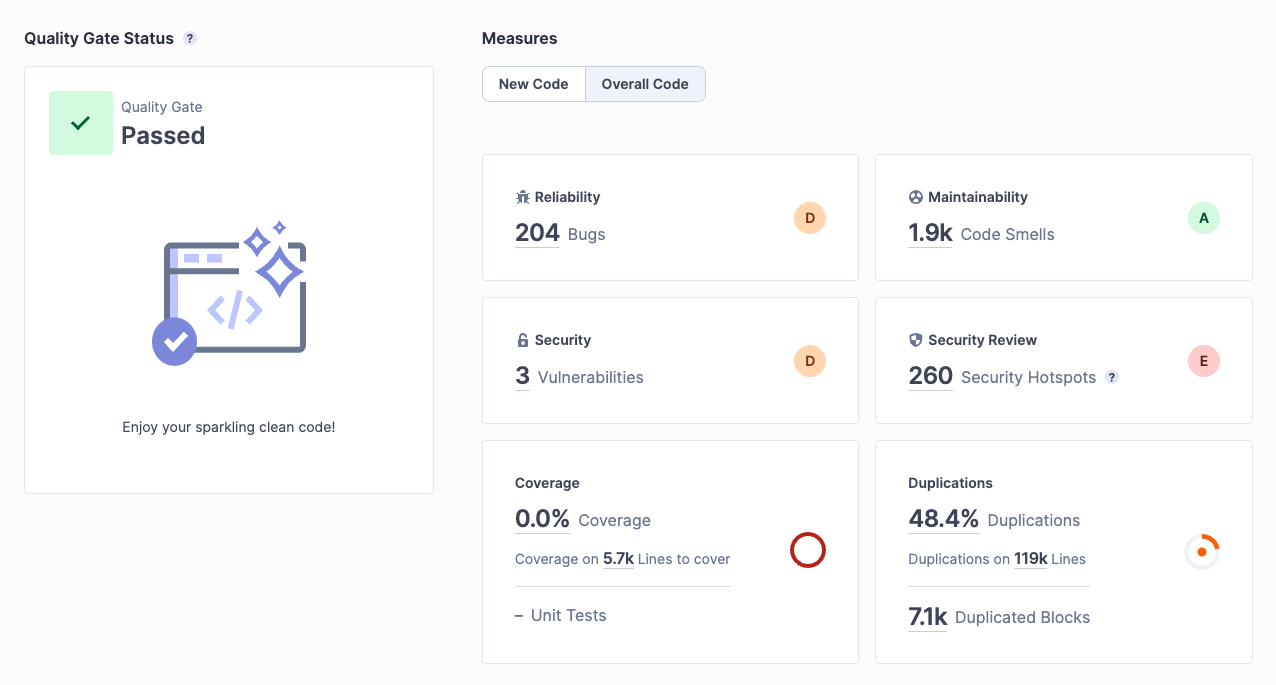
Hay que tener en cuenta que la clasificación clásica de las incidencias en bug, vulnerabilidad y code smell está obsoleta en las versiones recientes de SonarQube. Las incidencias se vinculan ahora a atributos de clean code y a las cualidades del software a las que afectan, como se explica más abajo.
Security hotspots y vulnerabilidades
SonarQube distingue entre dos conceptos de seguridad que conviene no confundir.
Un security hotspot es un fragmento de código sensible desde el punto de vista de la seguridad que la herramienta destaca, pero que no afecta necesariamente a la seguridad general de la aplicación. Por ejemplo, el uso de una función criptográfica o la lectura de una variable de entorno pueden ser correctos o no según el contexto. Corresponde al desarrollador revisar el código y determinar si es necesaria una corrección para asegurarlo. El hotspot es, por tanto, una invitación a la revisión humana, no un veredicto.
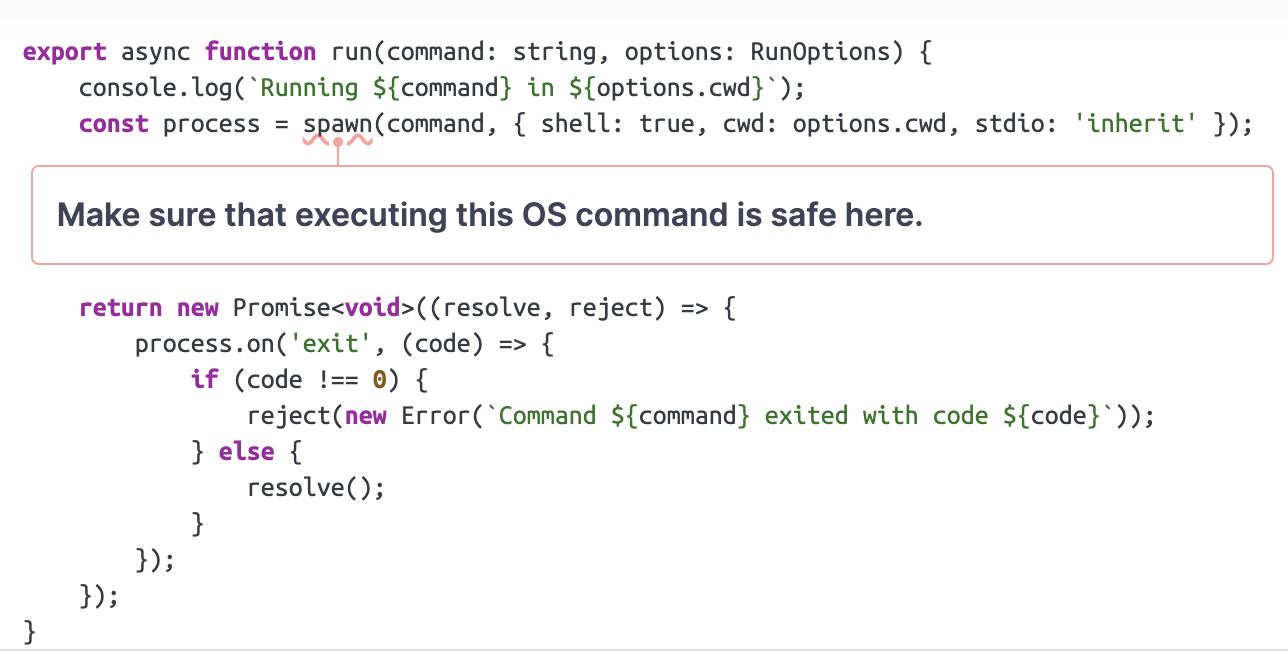
Una vulnerabilidad, en cambio, es un problema que impacta en la seguridad de la aplicación y que debe arreglarse inmediatamente. Aquí la herramienta tiene suficiente información para afirmar que el código es explotable.
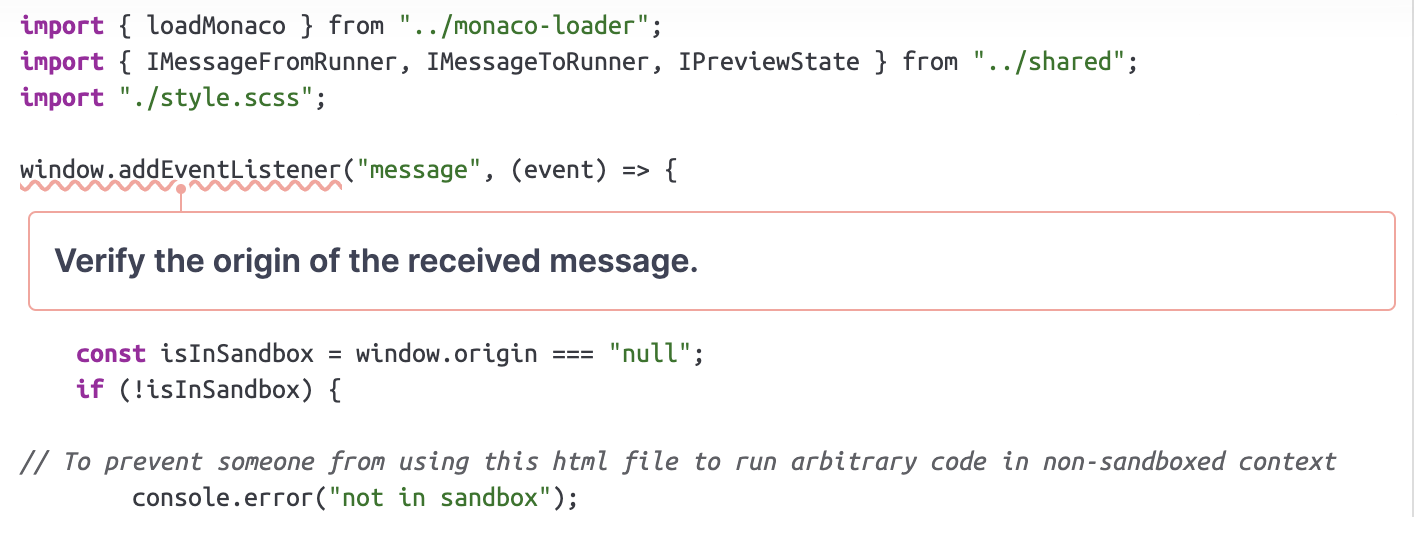
La distinción tiene consecuencias prácticas en el pipeline: es razonable que una vulnerabilidad haga fallar la construcción, mientras que un hotspot debería generar una tarea de revisión.
Clean code
El enfoque actual de SonarQube se organiza en torno al concepto de clean code, que articula tres nociones:
- Atributos de clean code: propiedades que debe tener el código, como ser consistente, intencional, adaptable o responsable.
- Cualidades del software: el clean code conduce a un software que es seguro, fiable y mantenible. Estos tres aspectos son las cualidades del software en la terminología de Sonar, y contribuyen al valor a largo plazo del producto.
- Incidencias (issues): una incidencia es un problema en el código que impide que sea clean code. Cada incidencia está vinculada a un atributo de clean code, que a su vez se asocia con una o más cualidades del software, cada una con un nivel de gravedad.
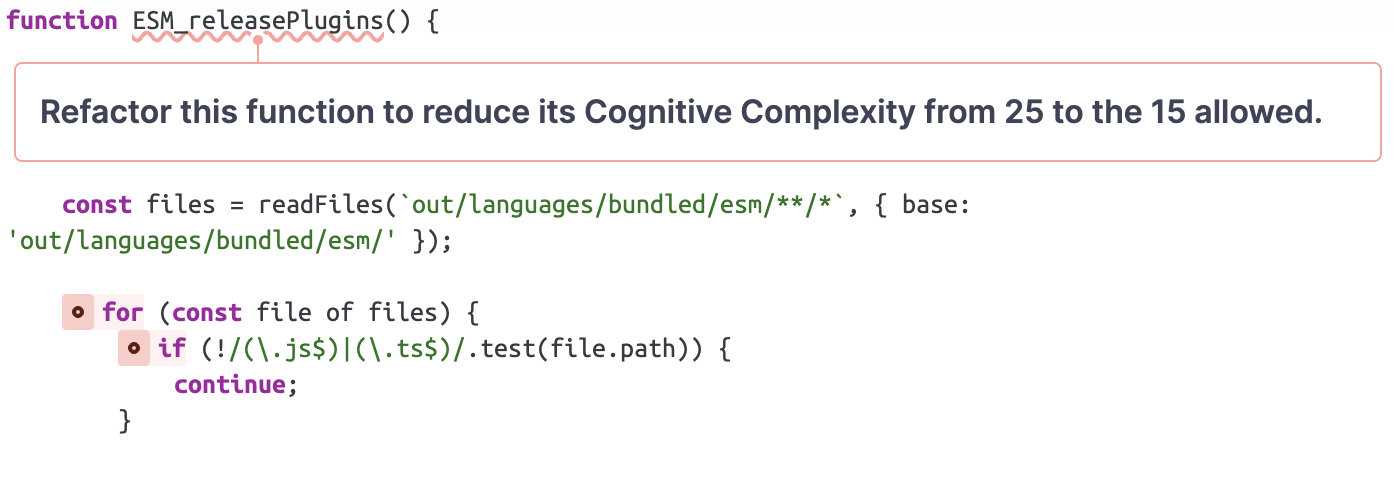
La figura muestra, como ejemplo, una incidencia de mantenibilidad causada por una complejidad cognitiva excesiva. Puede parecer ajena a la seguridad, pero no lo es: el código difícil de entender es también difícil de revisar, y los defectos de seguridad se esconden con más facilidad en él. Este enfoque refleja bien la idea, ya presente en la discusión sobre requisitos no funcionales, de que la seguridad no es independiente de la calidad general del software.
SCA: Software Composition Analysis
El análisis de composición del software (SCA, Software Composition Analysis) se ocupa de una parte del código que el SAST tradicional no examina: los componentes de terceros o dependencias. Las aplicaciones modernas están formadas en gran medida por bibliotecas y frameworks externos, que a su vez dependen transitivamente de otros componentes. Cada uno de ellos puede contener vulnerabilidades, y el equipo de desarrollo hereda todas ellas al incorporarlos.
El SCA puede caracterizarse por tres funciones:
- Es un proceso automático que identifica y analiza las dependencias de un proyecto, construyendo un inventario de todos los componentes que lo forman, incluidos los transitivos.
- Busca y repara vulnerabilidades existentes en esas dependencias, contrastándolas con bases de datos de vulnerabilidades conocidas y proponiendo, cuando existe, la versión que corrige el problema (como hacía
safety checken el ejemplo derequests). - Monitoriza continuamente las dependencias y permite corregirlas rápidamente cuando se descubren nuevas vulnerabilidades. Este último punto es fundamental: una dependencia que hoy es segura puede dejar de serlo mañana, cuando se publique una nueva vulnerabilidad, sin que haya cambiado una sola línea del proyecto.
Snyk
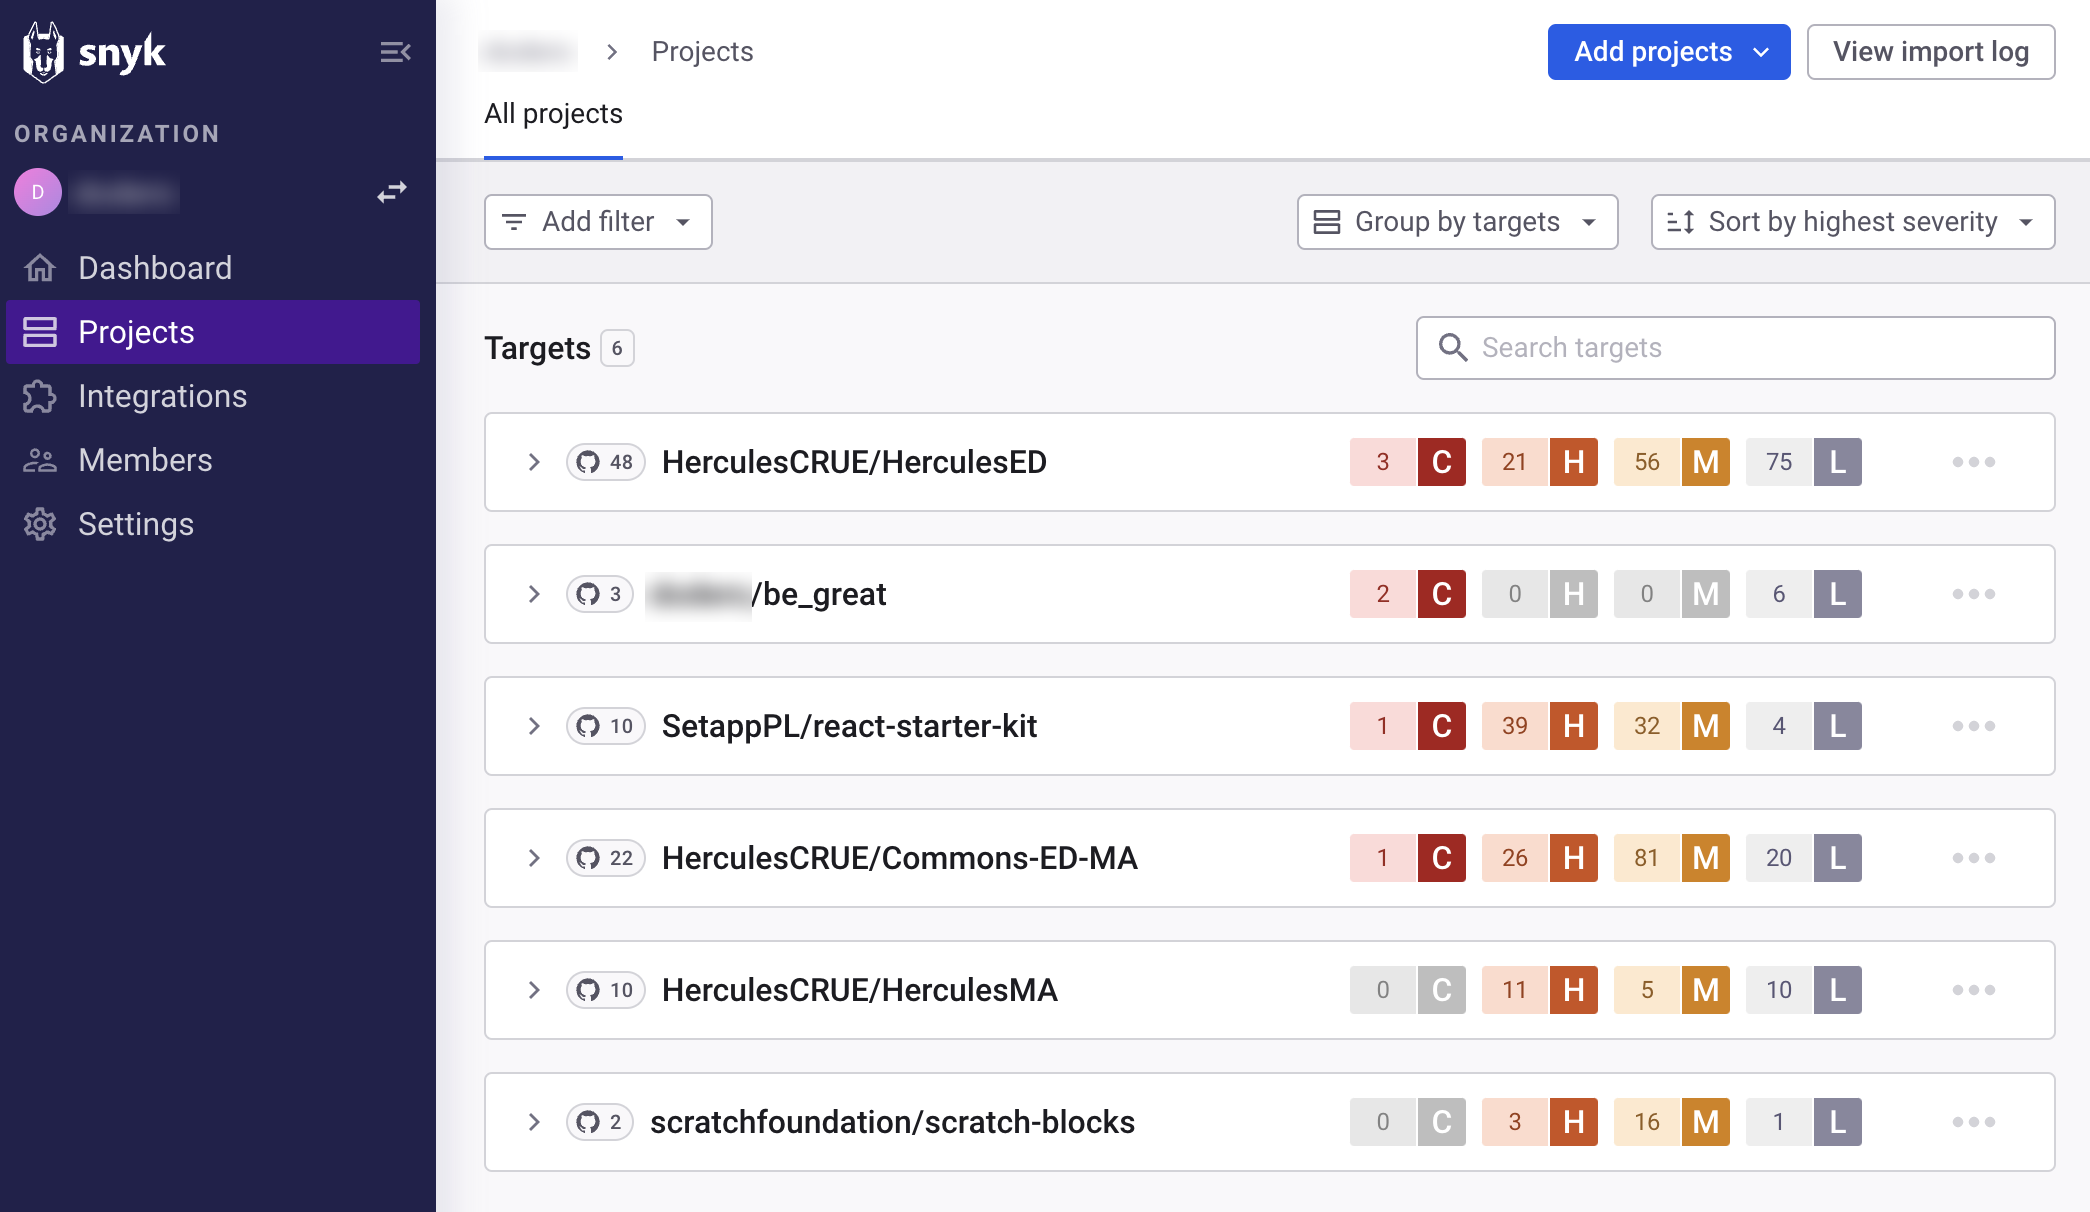
Snyk es una de las herramientas SCA más utilizadas. La figura muestra su panel de proyectos, en el que cada repositorio conectado aparece con un resumen de las vulnerabilidades detectadas en sus dependencias, clasificadas por gravedad. Snyk puede conectarse directamente a repositorios de GitHub para monitorizarlos de forma continua y abrir automáticamente propuestas de cambio que actualizan las dependencias vulnerables, y también puede invocarse desde el pipeline de CI, como se hacía en el ejemplo de GitHub Actions con la acción snyk/actions/python y la orden test.
Deep SAST
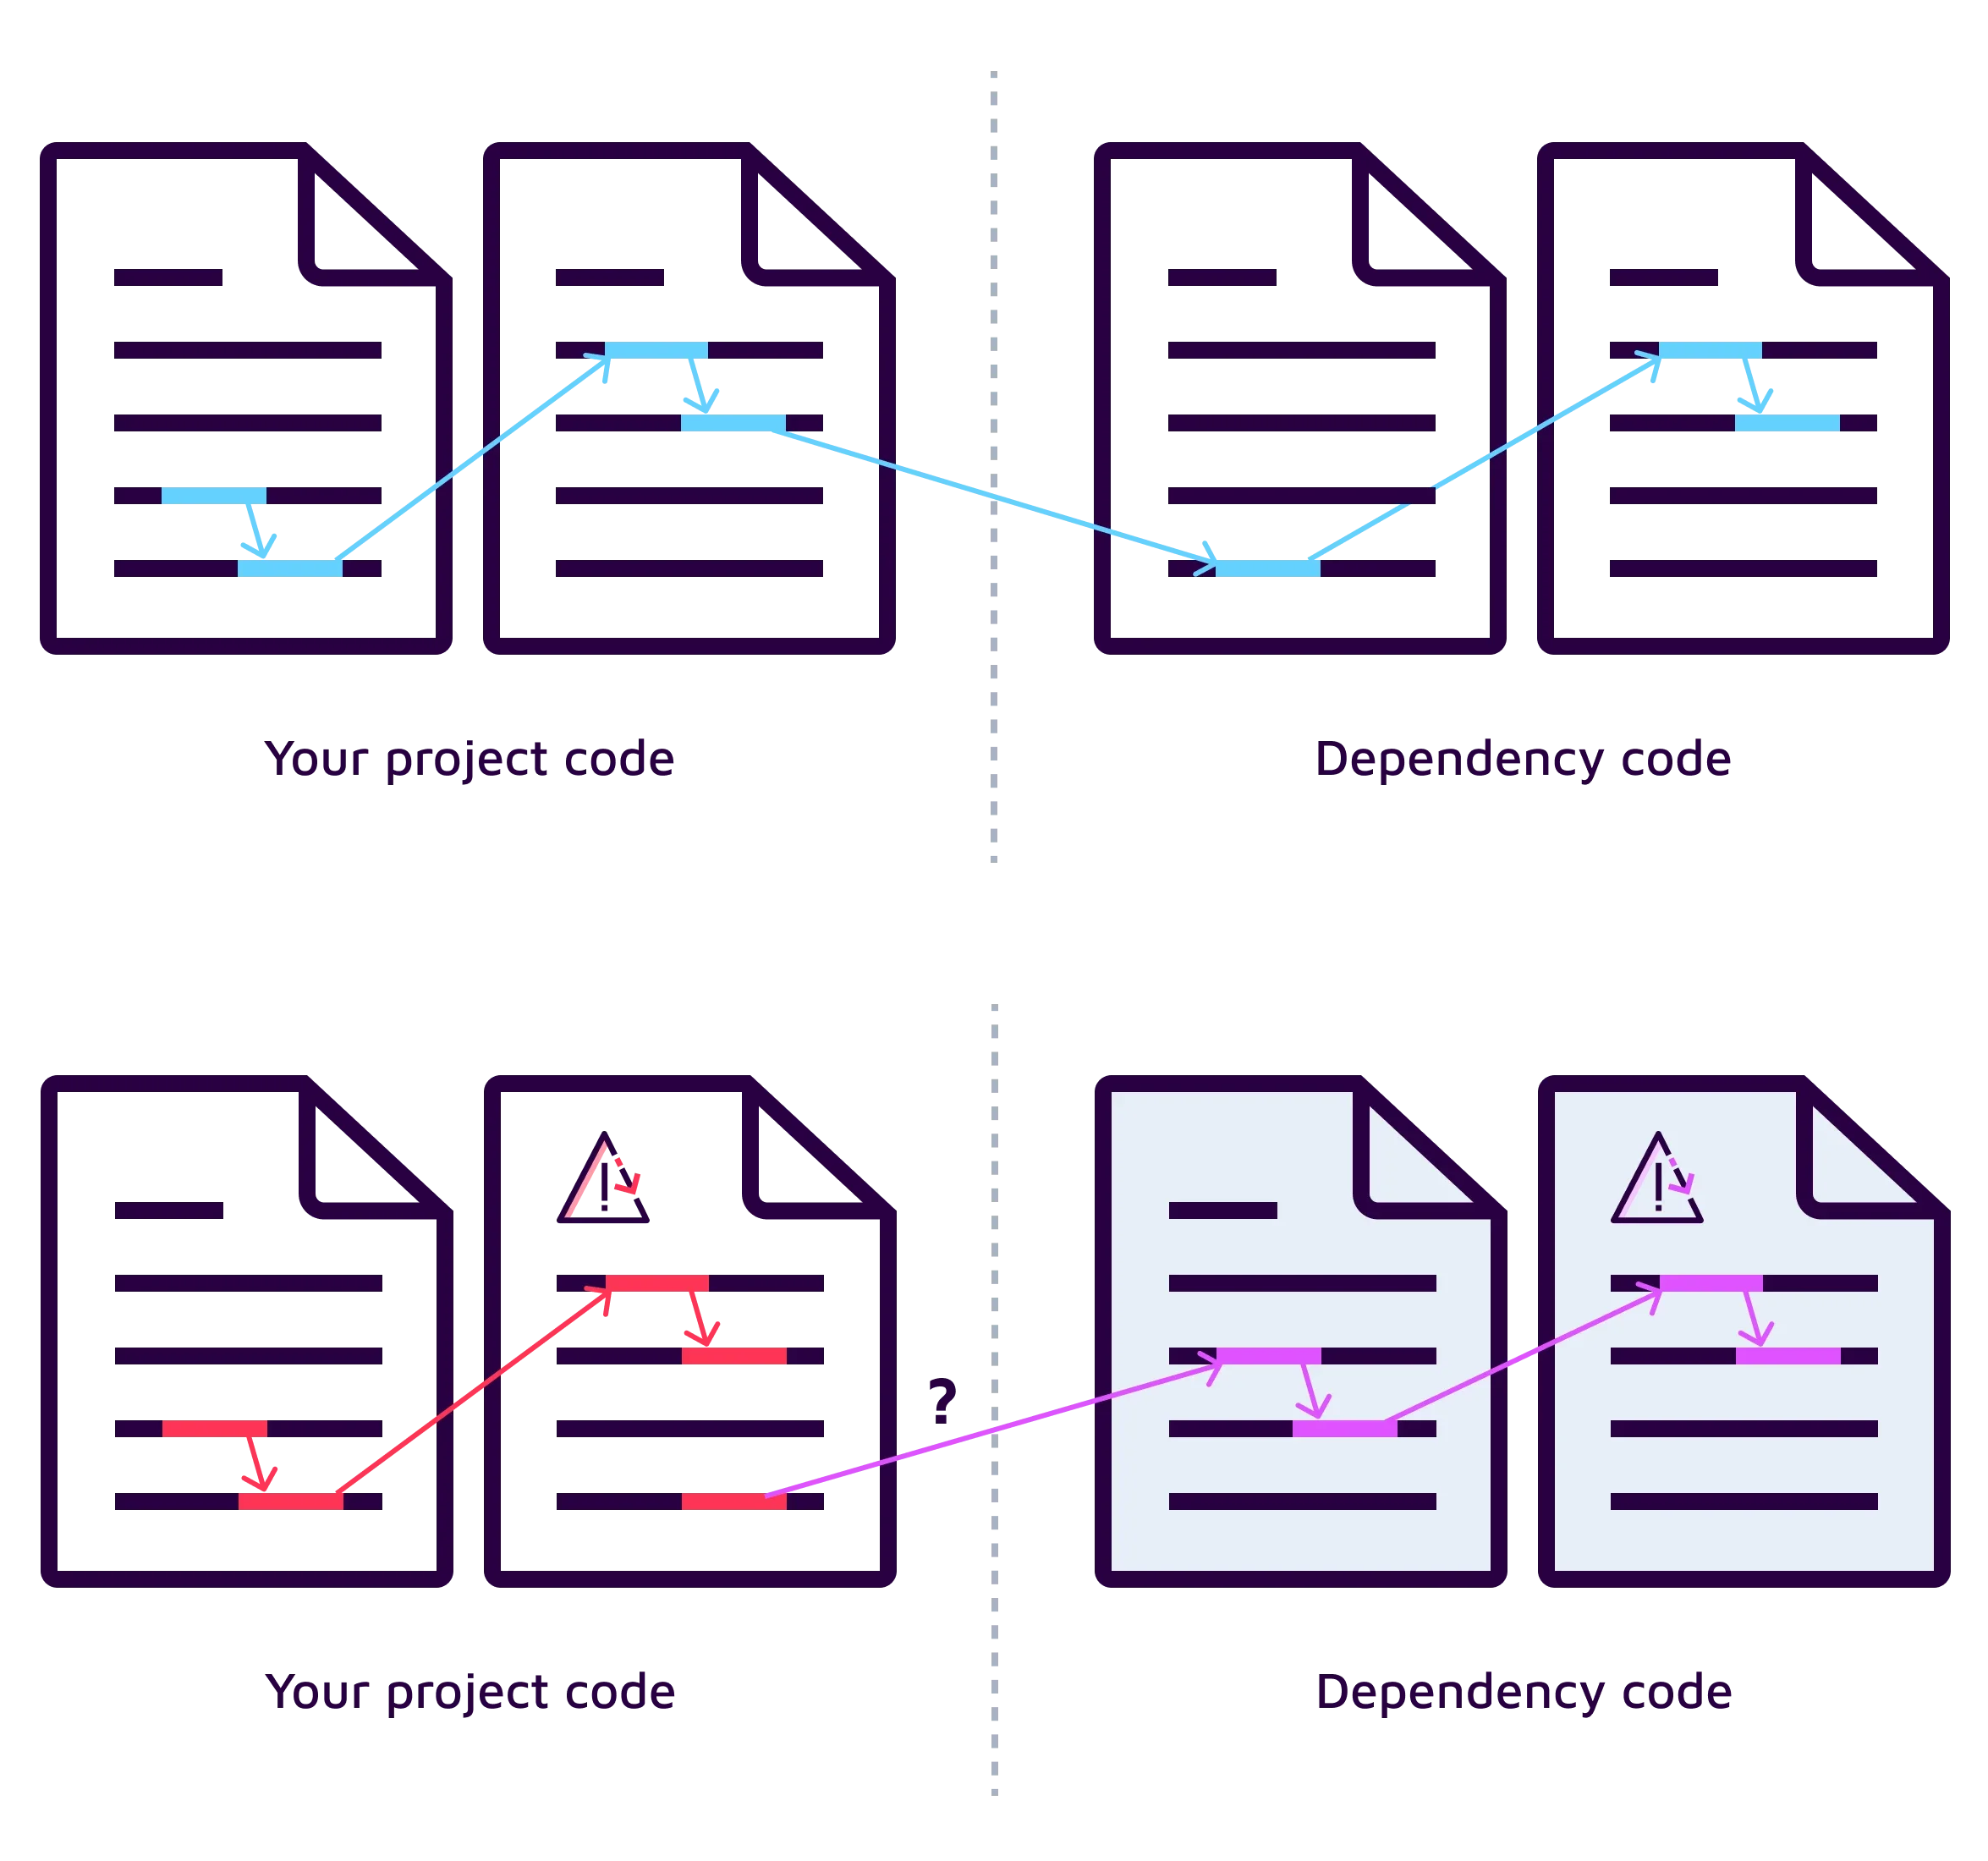
SAST y SCA, tal como se han descrito, dejan un hueco entre ellos. SAST analiza el código propio de la aplicación, pero no el de las dependencias. SCA informa de problemas en las dependencias basándose en una base de datos de vulnerabilidades conocidas, lo que constituye solo una pequeña parte del problema. El llamado deep SAST (o deeper SAST) intenta cubrir ese hueco analizando cómo interactúa el código de la aplicación con el de los frameworks, las bibliotecas y las dependencias transitivas. SonarSource explica este enfoque en el artículo Hidden Security Vulnerabilities.
Vulnerabilidades de contaminación (taint)
El principal objetivo del deep SAST son las vulnerabilidades de contaminación o taint, que son defectos de inyección de código. Entre ellas se encuentran la inyección SQL, la deserialización insegura y la inyección de comandos. Su explotación puede tener consecuencias dramáticas: filtrar datos confidenciales, ejecutar código malicioso o tomar el control del servidor.
Lo que hace difíciles de detectar estas vulnerabilidades es que no se manifiestan en una sola línea de código, sino en la interacción entre múltiples secuencias de código que se encuentran en distintos ficheros y funciones. Cada secuencia, por sí misma, puede ser inofensiva; es su combinación la que resulta insegura. El análisis de contaminación sigue el recorrido de un dato desde una fuente no confiable (por ejemplo, un parámetro de una petición HTTP) hasta un sumidero sensible (por ejemplo, una consulta a la base de datos), comprobando si en algún punto del camino el dato se valida o se neutraliza.
Frameworks, bibliotecas y dependencias transitivas
Comprender las implicaciones de seguridad de un código que procede de múltiples fuentes (frameworks, bibliotecas, etc.) es muy difícil. Las dependencias, como el framework Spring o la biblioteca log4j, inducen una interacción con el código de la aplicación que puede dar lugar a vulnerabilidades; el caso de Log4Shell, la vulnerabilidad de log4j (CVE-2021-44228), es un ejemplo bien conocido. Se hizo pública en diciembre de 2021 y permitía ejecutar código de forma remota con solo conseguir que una aplicación registrara en su log una cadena manipulada, algo tan habitual como guardar la cabecera de una petición HTTP; como log4j está presente, a menudo de forma transitiva, en una enorme cantidad de aplicaciones Java, su impacto fue mundial. Si revisar manualmente el código propio de una aplicación ya es complicado, revisar además el código de todas sus dependencias transitivas es, en la práctica, imposible.
Por qué SCA no es suficiente
SCA solo detecta vulnerabilidades registradas en bases de datos públicas. Pero el hecho de que una característica de una dependencia pueda utilizarse de forma insegura desde el código no significa que la dependencia sea vulnerable en sí misma. Una función de biblioteca puede ser perfectamente correcta y, aun así, convertirse en un sumidero peligroso si la aplicación le pasa datos no validados. Una base de datos de SCA nunca va a registrar una vulnerabilidad de este tipo, que es única de cada aplicación porque la causa la forma concreta en que se usa la dependencia en el código propio. Por lo tanto, esas vulnerabilidades pasan desapercibidas tanto para el SAST tradicional, que no sabe qué hace la función de la biblioteca, como para el SCA, que no la considera vulnerable.
Los dos ejemplos siguientes, tomados de un proyecto de demostración de SonarSource, ilustran este tipo de vulnerabilidades.
Deep SAST, ejemplo 1: inyección SQL
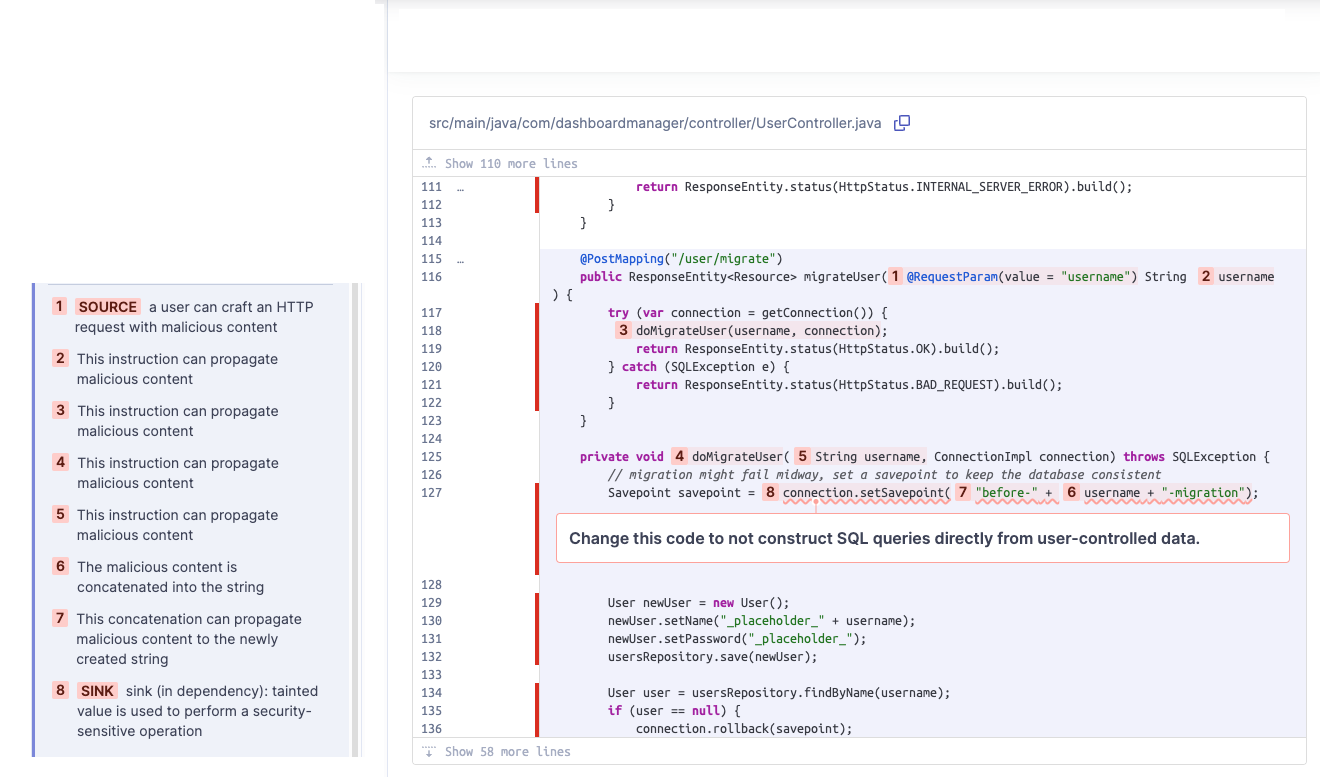
La incidencia puede consultarse en SonarCloud: SQL injection.
El fragmento de código realiza una migración de base de datos para un usuario específico. Recupera un nombre de usuario proporcionado por el propio usuario (paso [1] de la traza) que se utiliza como parte del nombre de un punto de salvaguarda (savepoint) de la base de datos (paso [7]). El punto de salvaguarda se crea con una función de la biblioteca de nombre aparentemente inocente, setSavepoint() (paso [8]).
Ni un desarrollador ni una herramienta SAST tradicional pueden adivinar que esa función concreta es susceptible de inyección SQL, porque su nombre no lo sugiere y su implementación está en el código de la biblioteca. Sin embargo, un atacante puede proporcionar un nombre de usuario malicioso con sintaxis SQL que acabe insertado en la sentencia que crea el punto de salvaguarda, modificando así la consulta a la base de datos. El deep SAST detecta el problema porque conoce el comportamiento interno de setSavepoint() y puede seguir el dato contaminado desde la fuente [1] hasta el sumidero [8].
Deep SAST, ejemplo 2: deserialización
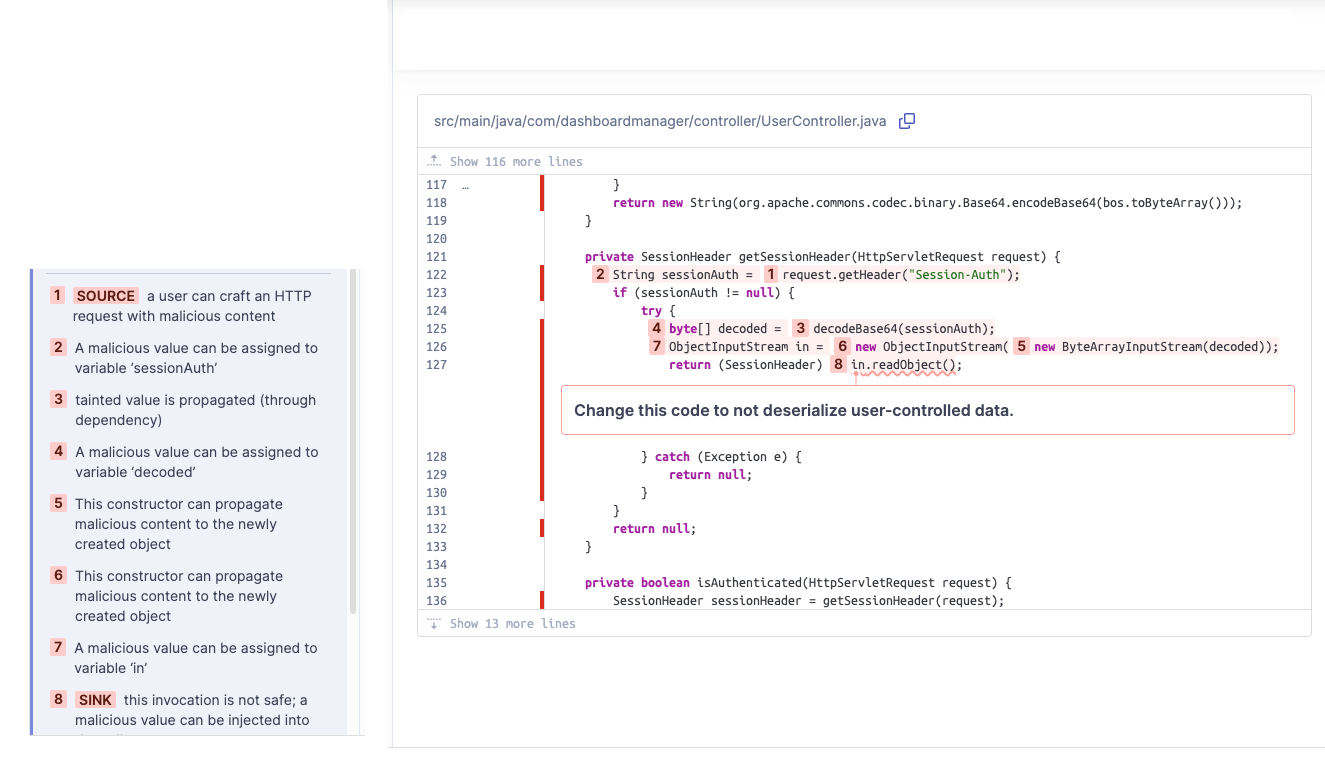
La incidencia puede consultarse en SonarCloud: Deserialization.
El fragmento de código muestra una vulnerabilidad de deserialización. El código recupera datos de la cabecera HTTP Session-Auth (paso [1]) y luego intenta reconstruir objetos Java a partir de esos datos (pasos [6] a [8]). Si un atacante puede manipular la cabecera HTTP, puede enviar objetos Java malformados o maliciosos, lo que le permite ejecutar código de forma remota.
El paso crítico se produce en [3], donde la función externa decodeBase64() procesa los datos. Si la herramienta SAST no sabe lo que hace esta función, no puede establecer la conexión entre la fuente [1] y el sumidero [8], porque pierde el rastro del dato contaminado al pasar por código de terceros, y no detectará la vulnerabilidad. El deep SAST sí modela que la salida de decodeBase64() sigue estando contaminada cuando su entrada lo está, y por eso puede reconstruir la traza completa.
Ambos ejemplos ilustran la misma lección: las vulnerabilidades más graves no siempre están en el código propio ni en dependencias catalogadas como vulnerables, sino en la interacción entre ambos. Detectarlas requiere herramientas que entiendan el flujo de datos a través de toda la aplicación.
Ideas clave
- DevSecOps integra la seguridad en todo el ciclo de vida del software como una responsabilidad compartida y automatizada, y se apoya en cuatro dimensiones: personas, procesos, tecnología y gobernanza.
- DevOps no es un rol ni un equipo, sino una cultura que une personas, procesos y productos para entregar valor de forma continua, extendiendo la agilidad a desarrollo, negocio y operaciones. La IA generativa está poniendo en cuestión prácticas ágiles pensadas para equipos de personas, como los sprints, las dailies o los roles.
- Integración continua, entrega continua y despliegue continuo son prácticas distintas y acumulativas; cada una tiene su propio pipeline, y en ellos es donde se insertan los controles automáticos de seguridad. Aunque se traduzcan de forma parecida, no hay que confundir build con construction, release con delivery ni delivery con deploy.
- La infraestructura como código permite que la infraestructura sea versionada, revisable, idempotente y analizable, de modo que errores como un bucket público o una imagen base vulnerable se detectan antes del despliegue.
- Las principales familias de herramientas DevSecOps (SAST, SCA, DAST, IAST y escáneres de IaC y contenedores) son complementarias: cada una actúa en un momento distinto y cubre puntos ciegos de las demás. Las auditorías con agentes de IA y skills de seguridad se suman a ellas sin sustituirlas, y esas skills son a su vez código de terceros que también hay que analizar.
- SAST permite tratar la causa y no los síntomas, detectando vulnerabilidades en el código cuando todavía son baratas de corregir. Es más necesario que nunca con el código generado por IA, que reproduce patrones inseguros y se genera más deprisa de lo que se revisa: la brecha (o deuda) de verificación.
- SCA inventaría y monitoriza continuamente las dependencias frente a vulnerabilidades conocidas, como mostró el caso Log4Shell, pero no detecta los problemas causados por cómo usa la aplicación esas dependencias.
- El deep SAST sigue el flujo de datos contaminados a través del código propio y de las bibliotecas para descubrir vulnerabilidades de inyección y deserialización que ni el SAST tradicional ni el SCA detectan.